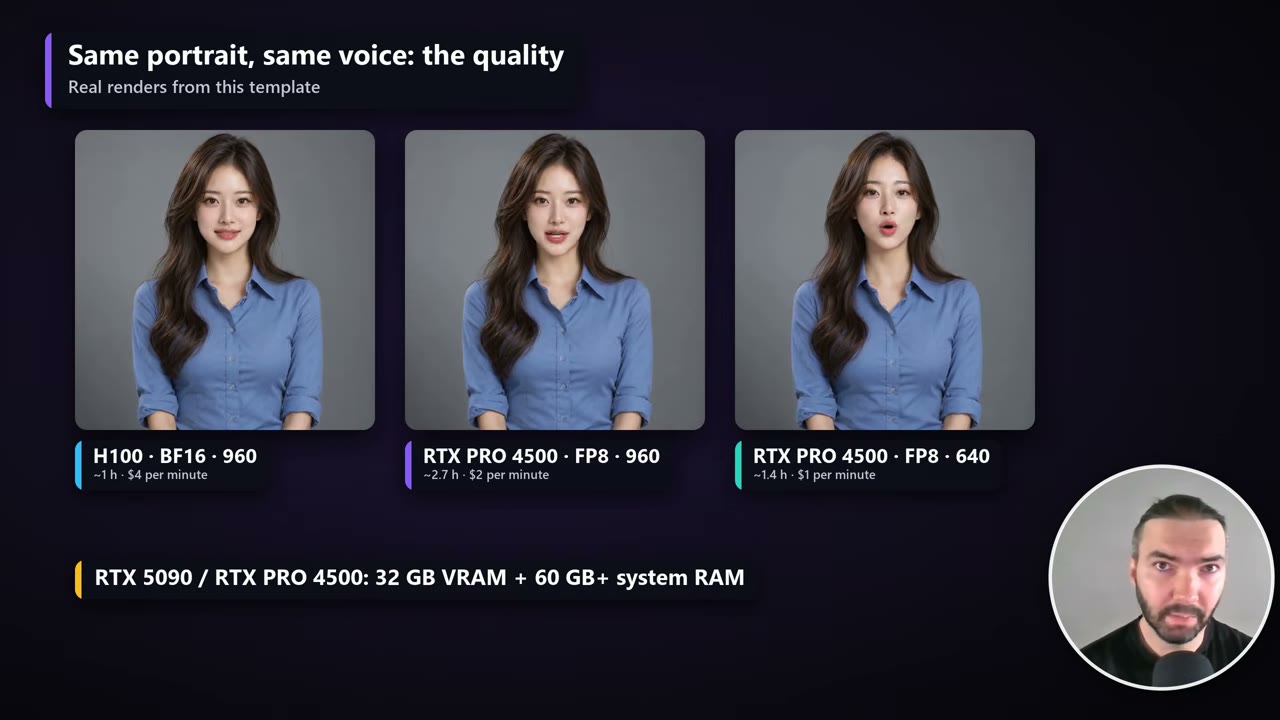
Status: Testado no RunPod. Renderizei com este template no RunPod em uma H100 SXM e uma RTX PRO 4500. Os tempos e custos deste guia vêm dessas execuções.
Estes são os avatares falantes de maior qualidade que renderizei até agora. O LongCat-Video-Avatar 1.5 é um modelo de pesos abertos da Meituan treinado especificamente com pessoas falando, não com vídeo genérico. Dê a ele um retrato e uma locução de qualquer duração, e ele devolve um vídeo com sincronização labial e o seu áudio original, inclusive com enquadramento de meio corpo e movimento das mãos.
A qualidade tem um preço: é um modelo pesado e renderiza devagar. Este guia cobre o template que montei para ele, como configurá-lo no RunPod, qual GPU escolher (a RAM do sistema importa tanto quanto a VRAM) e quanto um minuto pronto realmente custa.
Em resumo
- Custo por minuto pronto: cerca de US$ 4 em uma H100, US$ 2 em uma RTX PRO 4500 em 960 × 960 e US$ 1 em 640 × 640 (preços de outubro de 2026).
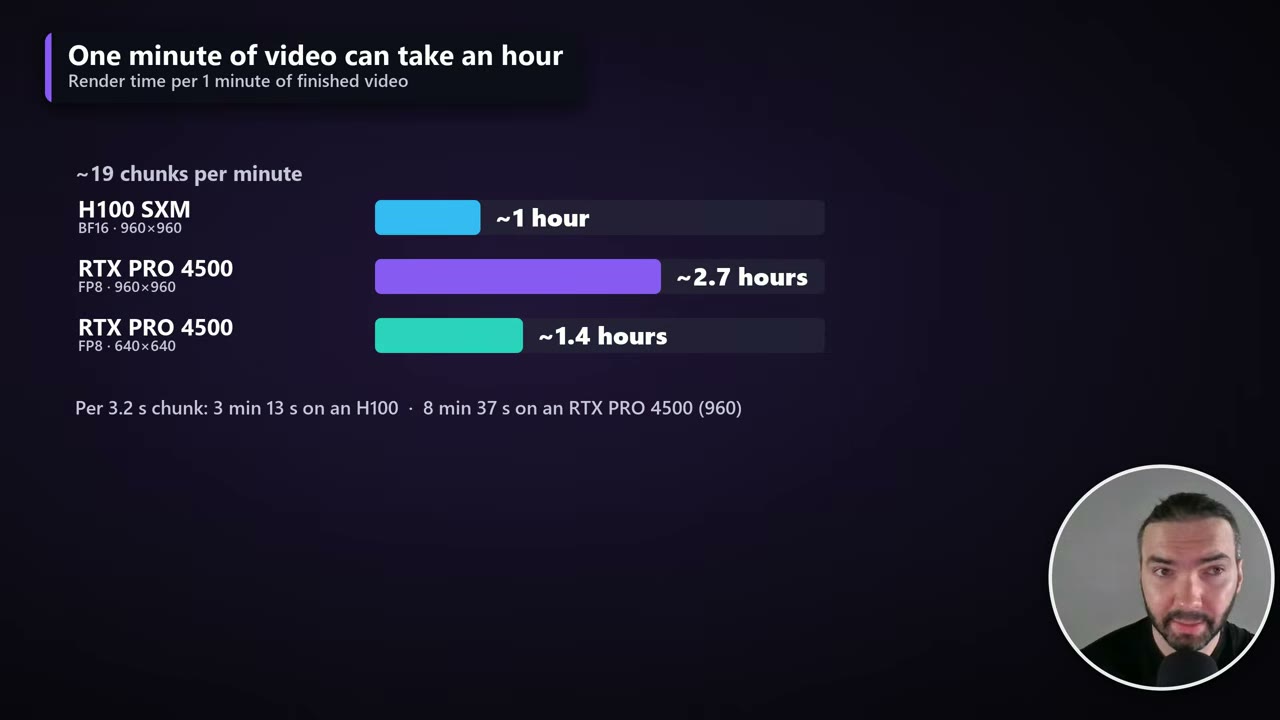
- Tempo de render por minuto pronto: cerca de 1 hora em uma H100, 1,4–2,7 horas em uma RTX PRO 4500.
- Hardware: pelo menos 32 GB de VRAM e mais de 60 GB de RAM do sistema.
- Como funciona: janelas de 3,7 segundos, cada uma continuando da anterior, então não há reinício a cada emenda. Um reinício a partir do retrato a cada 40–60 segundos, em uma pausa, impede que o rosto se desvie.
- Template gratuito no GitHub, ou um clique no RunPod.
Quanto custa
Estas são as minhas medições no RunPod em outubro de 2026, para um minuto de vídeo pronto:
| GPU | Modelo, tela | Preço | Tempo de render por minuto | Custo por minuto |
|---|---|---|---|---|
| H100 SXM | BF16, 960 × 960 | $4.00/h | ~1 hora | ~US$ 4,02 |
| RTX PRO 4500 | FP8, 960 × 960 | $0.72/h | ~2,7 horas | ~US$ 1,97 |
| RTX PRO 4500 | FP8, 640 × 640 | $0.72/h | ~1,4 hora | ~US$ 1,03 |
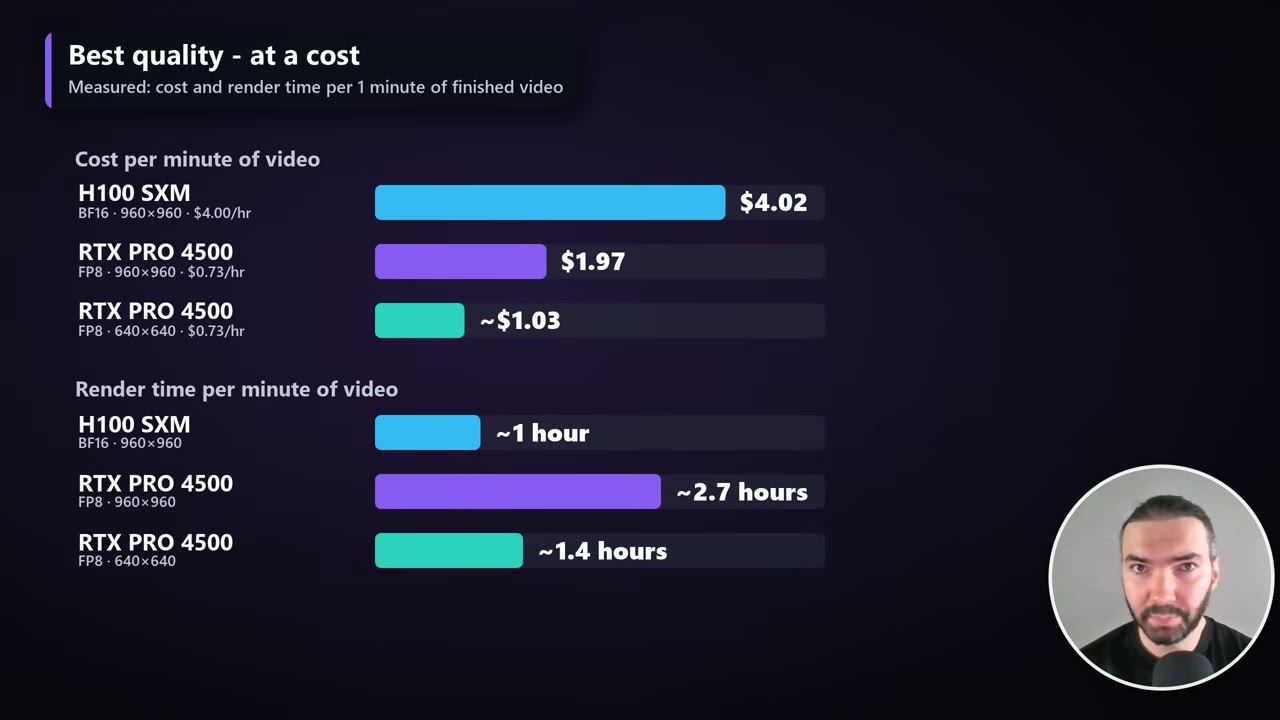
Um minuto de vídeo dá cerca de 19 trechos. Um trecho de 3,2 segundos levou cerca de 3 minutos e 13 segundos na H100 e cerca de 8 minutos e 37 segundos na RTX PRO 4500 em 960 × 960.
A qualidade: BF16 vs. FP8, 960 vs. 640
O template traz duas versões do modelo. BF16 é o modelo de precisão total para GPUs de 80 GB, como a H100. FP8 é uma cópia menor para placas de 32–48 GB, como a RTX 5090 ou a RTX PRO 4500. Aqui estão lado a lado:
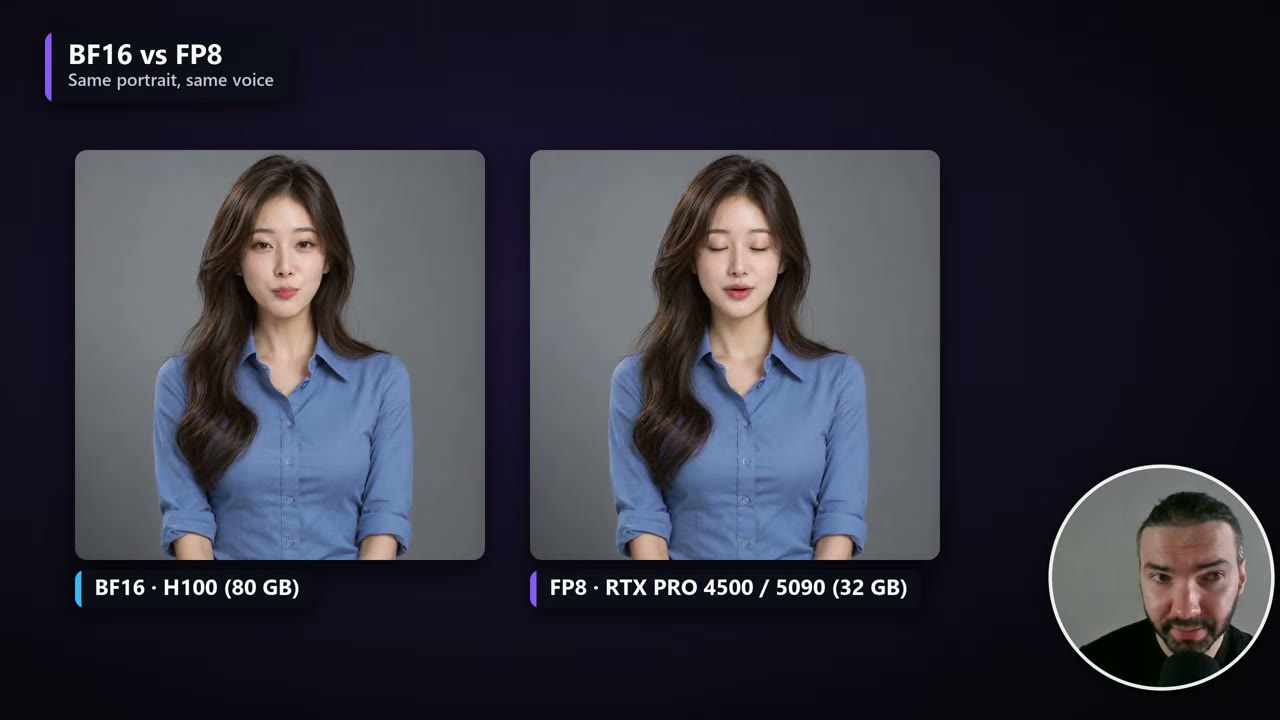
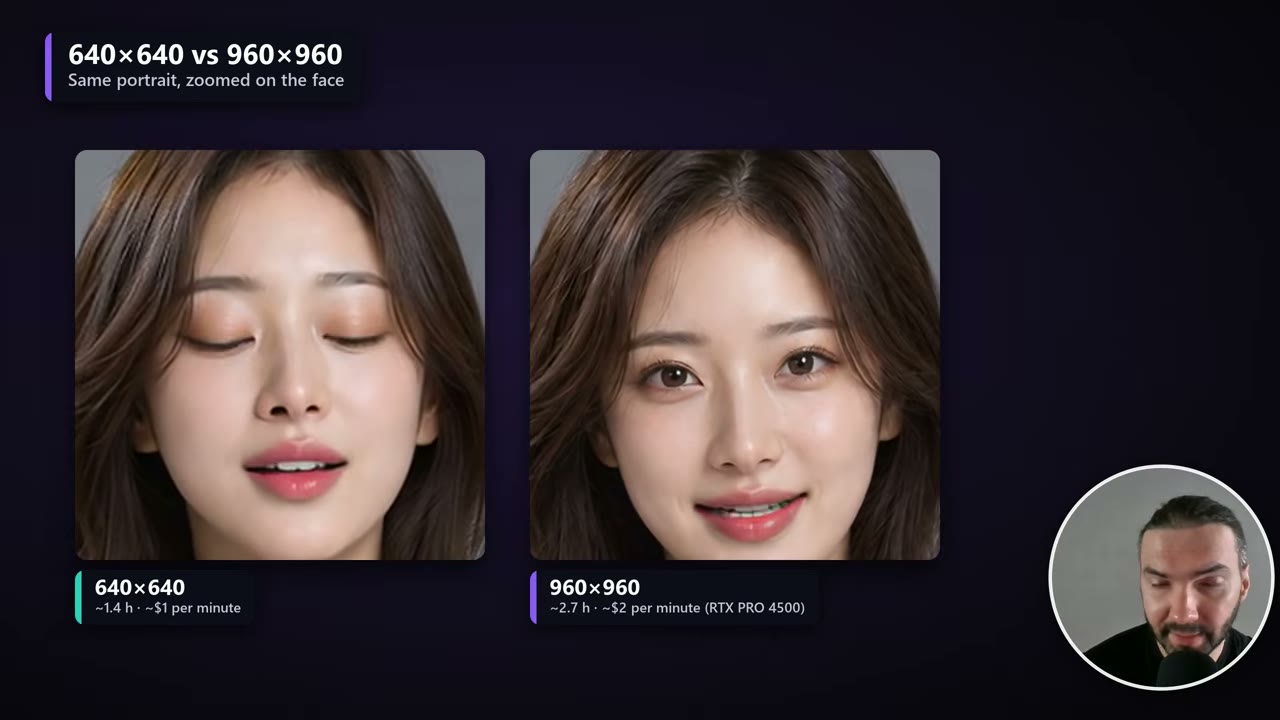
O tamanho da tela faz mais diferença. 960 × 960 fica visivelmente melhor que 640 × 640, e muito mais lento: se vale o custo extra, é você quem decide.
Duas formas de rodar
Tudo é gratuito no GitHub: os fluxos, os nós personalizados e o script de instalação.
- No RunPod: o template de um clique configura tudo. É o que o resto deste guia cobre.
- Localmente no ComfyUI: se você tiver o hardware, peça ao Claude (ou a qualquer IA) para baixar os arquivos do GitHub e instalá-los na ordem do
setup.sh. O ComfyUI não tem nós nativos do LongCat; o modelo roda pelo ComfyUI-WanVideoWrapper do kijai, que o script instala em um commit fixo.
Se você nunca usou o RunPod, minha introdução ao RunPod cobre contas, armazenamento e pods.
Armazenamento: volume global ou volume de rede
O RunPod agora tem dois tipos de armazenamento persistente, e o template funciona com os dois. Para este, mudei para um volume global.
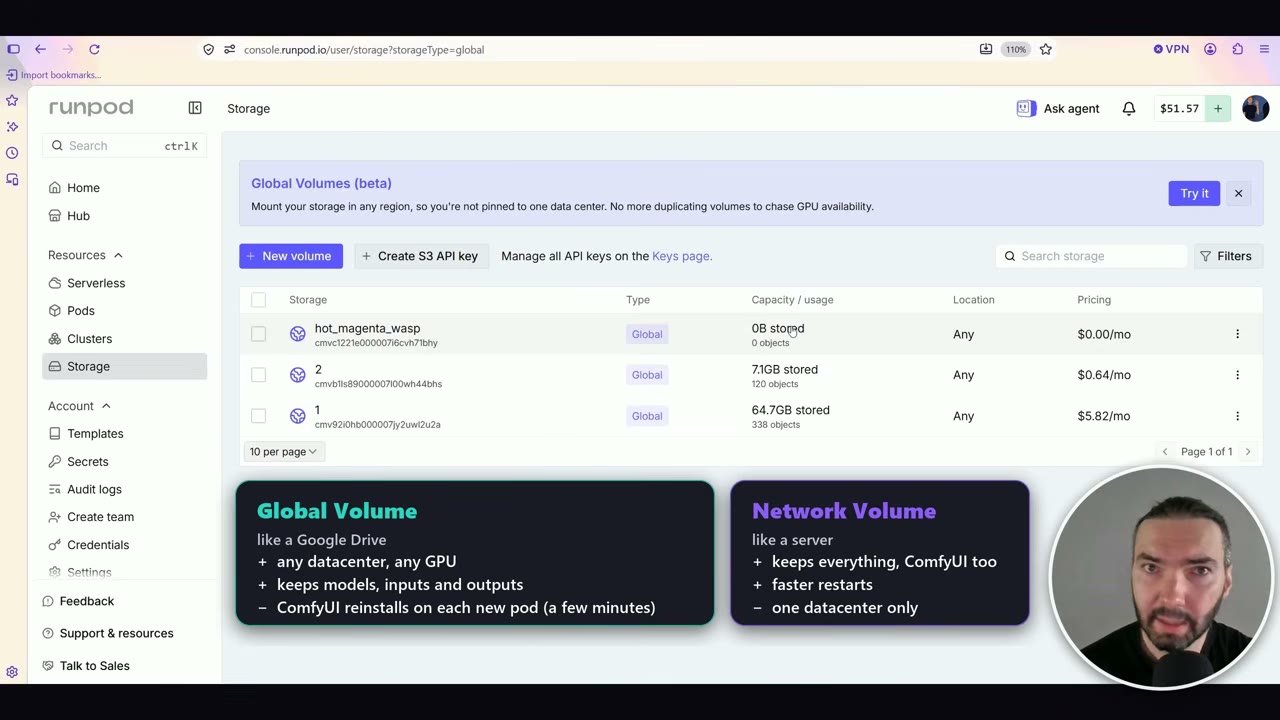
| Volume global | Volume de rede | |
|---|---|---|
| O que guarda | Modelos, entradas e saídas | Tudo, inclusive a instalação do ComfyUI |
| Onde dá para usar | Em qualquer data center, então há muito mais GPUs para escolher | Em um único data center |
| Tempo de reinício | Alguns minutos a mais: o ComfyUI é reinstalado a cada novo pod | Mais rápido |
| Preço (outubro de 2026) | US$ 0,09/GB por mês, só pelo que está armazenado | US$ 0,07/GB por mês pelo tamanho que você reserva, vazio ou não |
Para mim, o fator decisivo é a disponibilidade. Com um volume de rede você fica preso a um data center, e esse data center muitas vezes não tem GPUs livres. Um volume global pode ser anexado a uma GPU em qualquer lugar.
Também sai mais barato para mim, porque você só paga pelo que está realmente armazenado, cobrado por hora. Meu volume do LongCat tem 64,7 GB, o que dá US$ 5,82 por mês. Exclua-o quando quiser e a cobrança para.
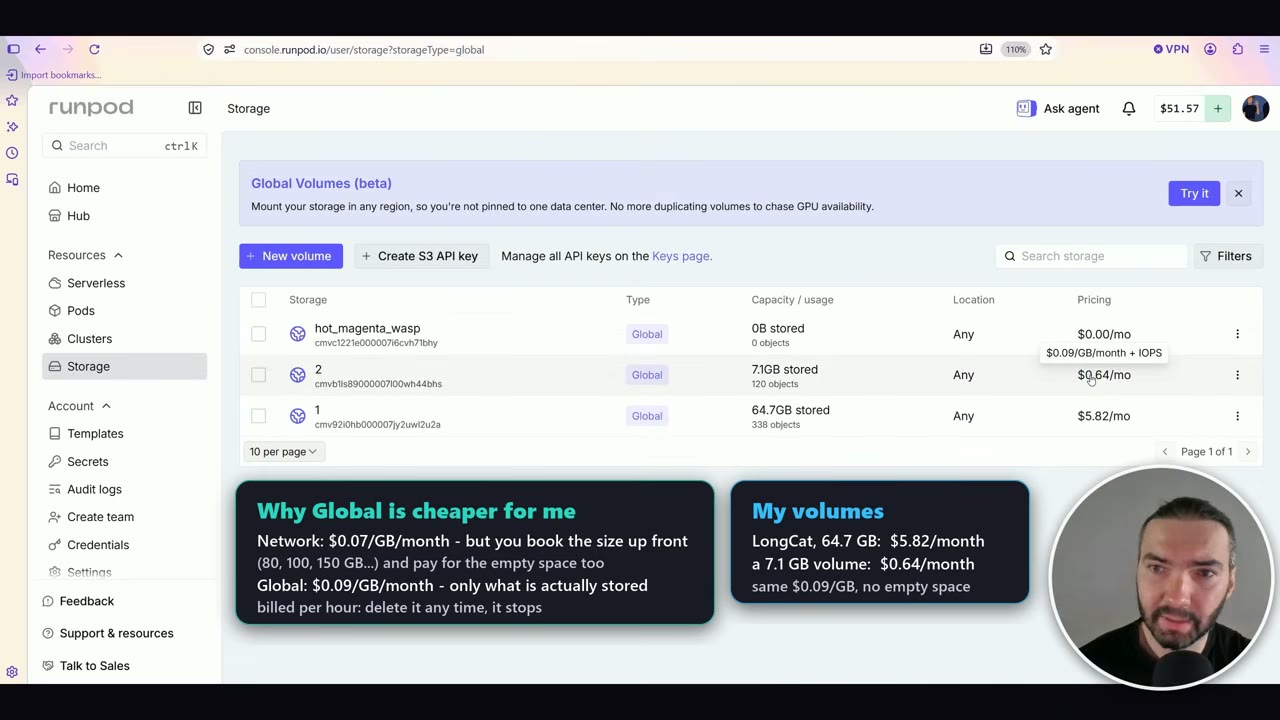
Os volumes globais ainda estão em beta. Uma coisa da documentação do RunPod que vale saber: se o saldo da sua conta chegar a US$ 0, o volume global é sinalizado e excluído permanentemente depois de 15 dias.
Para configurar: abra o link do template, vá em Storage → New volume, escolha Global volume, crie-o, depois selecione-o e clique em Configure Pod with volume. A página de implantação ainda não diz «Global» em lugar nenhum, mas o volume está anexado.
Qual GPU: VRAM e RAM do sistema
O LongCat precisa de pelo menos 32 GB de VRAM com o modelo FP8 e de mais de 60 GB de RAM do sistema. A RAM é a armadilha.
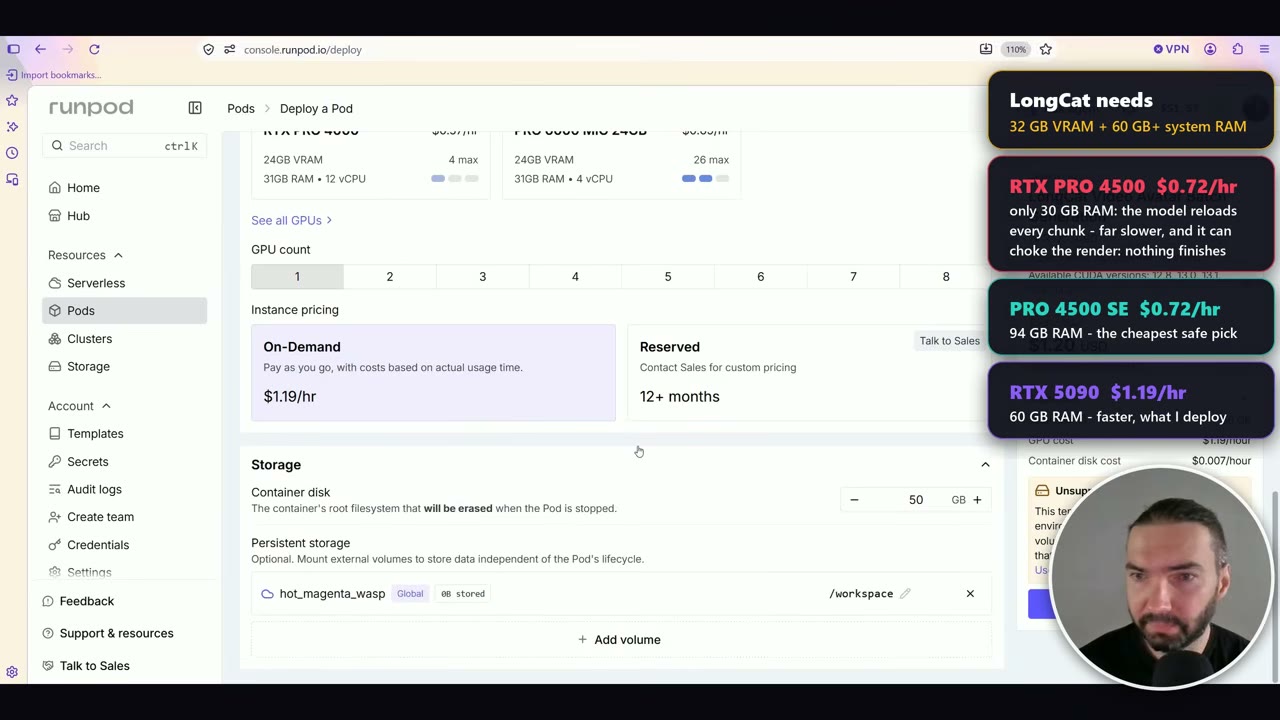
| GPU | VRAM | RAM do sistema | Preço (out. 2026) | Observações |
|---|---|---|---|---|
| RTX PRO 4500 | 32 GB | 30 GB | $0.72/h | Evite: o modelo é recarregado a cada trecho |
| RTX PRO 4500 SE | 32 GB | 94 GB | $0.72/h | A opção segura mais barata |
| RTX 5090 | 32 GB | 60 GB | $1.19/h | Mais rápida |
| H100 SXM | 80 GB | – | $4.00/h | Roda o modelo BF16 completo |
Com apenas 30 GB de RAM, o modelo precisa ser recarregado a cada trecho. Isso deixa o render muito mais lento e pode travá-lo por completo.
Implantação e primeira inicialização
- Implante o pod. Talvez você veja um aviso “Unsupported volume type” na página de implantação. Com este template, pode ignorá-lo sem problema.
- Se aparecer que não há recursos, clique em Deploy de novo. Às vezes o RunPod precisa de uma segunda tentativa.
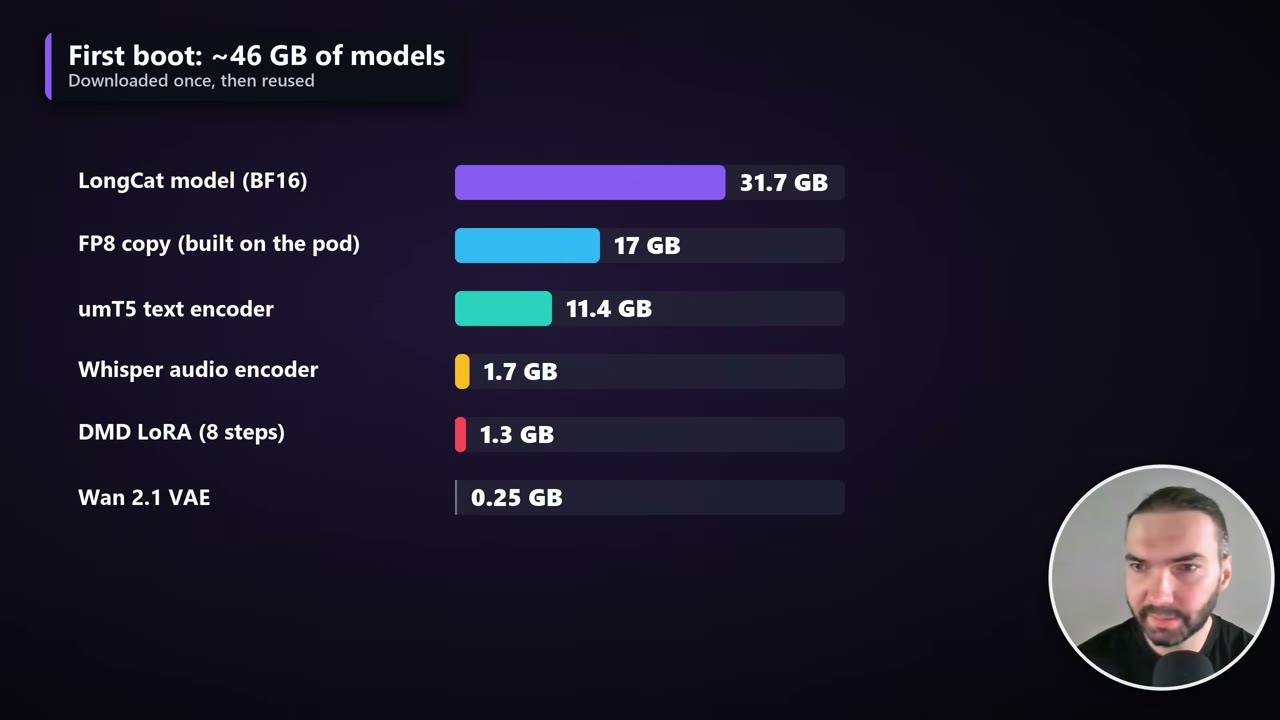
- Espere os downloads. A primeira inicialização baixa cerca de 46 GB de modelos, uma única vez. O pod também gera a cópia FP8 do modelo a partir do arquivo BF16, então os modelos ocupam cerca de 63 GB no total. As inicializações seguintes os reutilizam.
- Se tudo baixou, mas o ComfyUI não inicia, pare o pod e inicie-o de novo. Aconteceu comigo durante a gravação.
- Abra o ComfyUI e o JupyterLab pelo menu Connect do pod. O JupyterLab pode continuar dizendo «initializing» quando já está pronto, então tente abri-lo.
Os fluxos
Abra o ComfyUI e depois a barra lateral Workflows. Há oito fluxos: BF16 ou FP8, 640 × 640 ou 960 × 960, e uma versão de locução única ou em lote de cada um.
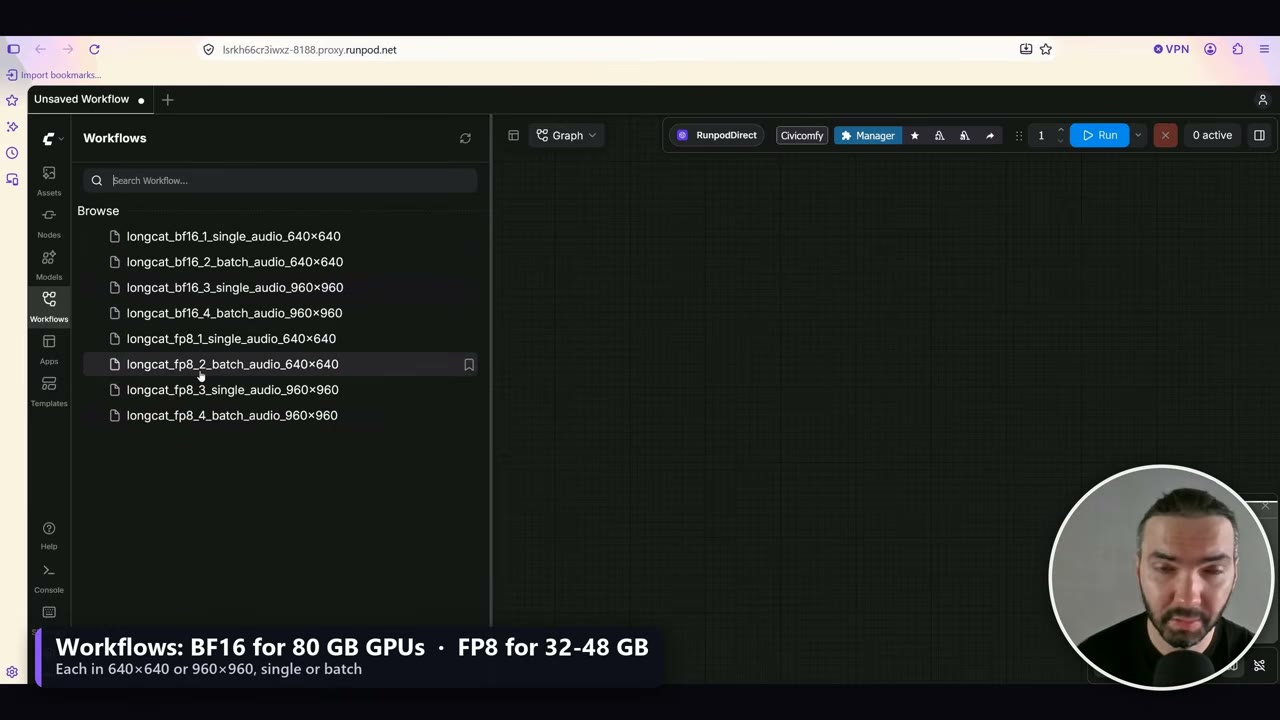
- Single audio renderiza uma locução. Ele abre com um retrato de exemplo e uma locução de exemplo de cerca de um minuto, então você pode testar na hora.
- Batch audio renderiza todas as locuções em
ComfyUI/input/batch_audio/, um vídeo para cada, uma após a outra, com o mesmo retrato.
Envie seus próprios retratos e locuções pelo JupyterLab: retratos para ComfyUI/input/ e locuções do lote para ComfyUI/input/batch_audio/.
O prompt é opcional. Para um avatar falante normal, deixe-o em branco. Você pode pedir algo específico, como “natural hand movement”.
Mantenha as mãos no retrato
O LongCat consegue mover as mãos muito bem. Mas, se as mãos não estiverem no seu retrato, o modelo precisa inventá-las quando entram no quadro, e nem sempre inventa as mesmas.
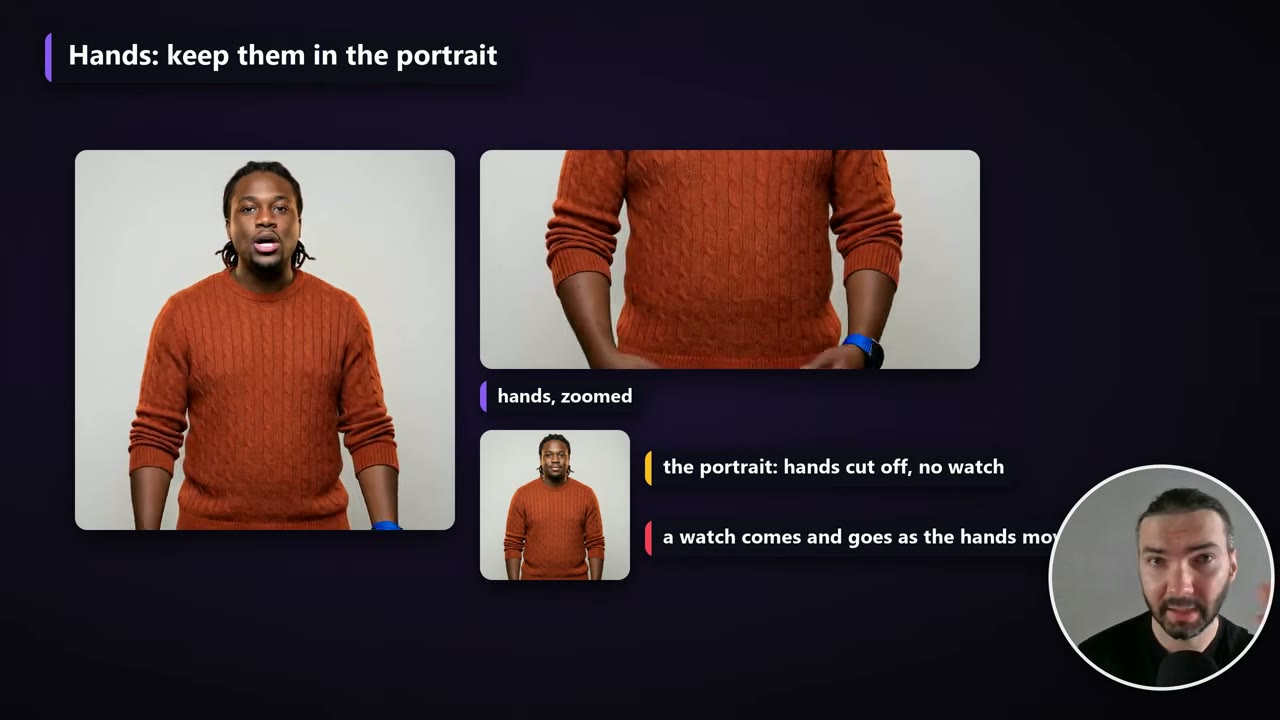
Se você quer movimento das mãos, use um retrato com as mãos visíveis, para que o modelo saiba que as mãos originais não tinham relógio. Ainda não é garantia, mas reduz o risco.
Como o LongCat evita o desvio em vídeos longos
Todo modelo de avatar renderiza em trechos: nenhum deles renderiza um minuto inteiro de uma vez. As janelas do LongCat têm 3,7 segundos, e é aí que ele se diferencia dos outros.
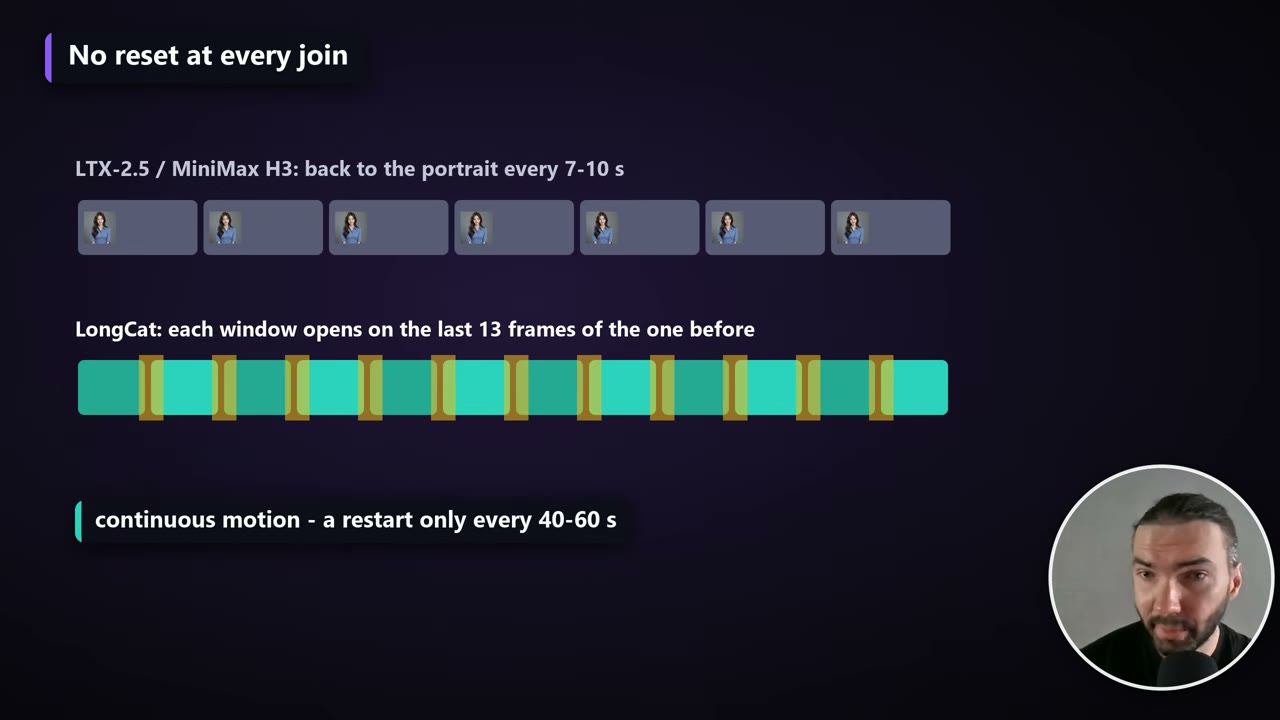
Com meus templates do LTX-2.5 e do MiniMax H3, cada trecho volta ao retrato original. O LongCat abre cada janela com os últimos 13 quadros da anterior, então o movimento é contínuo e não dá para ver as emendas. A sincronização labial também se mantém entre elas.
Só que a continuação tem seu próprio problema. Ela fica estável por cerca de 40–70 segundos; depois disso, o rosto começa a mudar e o ruído se acumula, piorando cada vez mais ao longo de um vídeo de 10 ou 20 minutos.
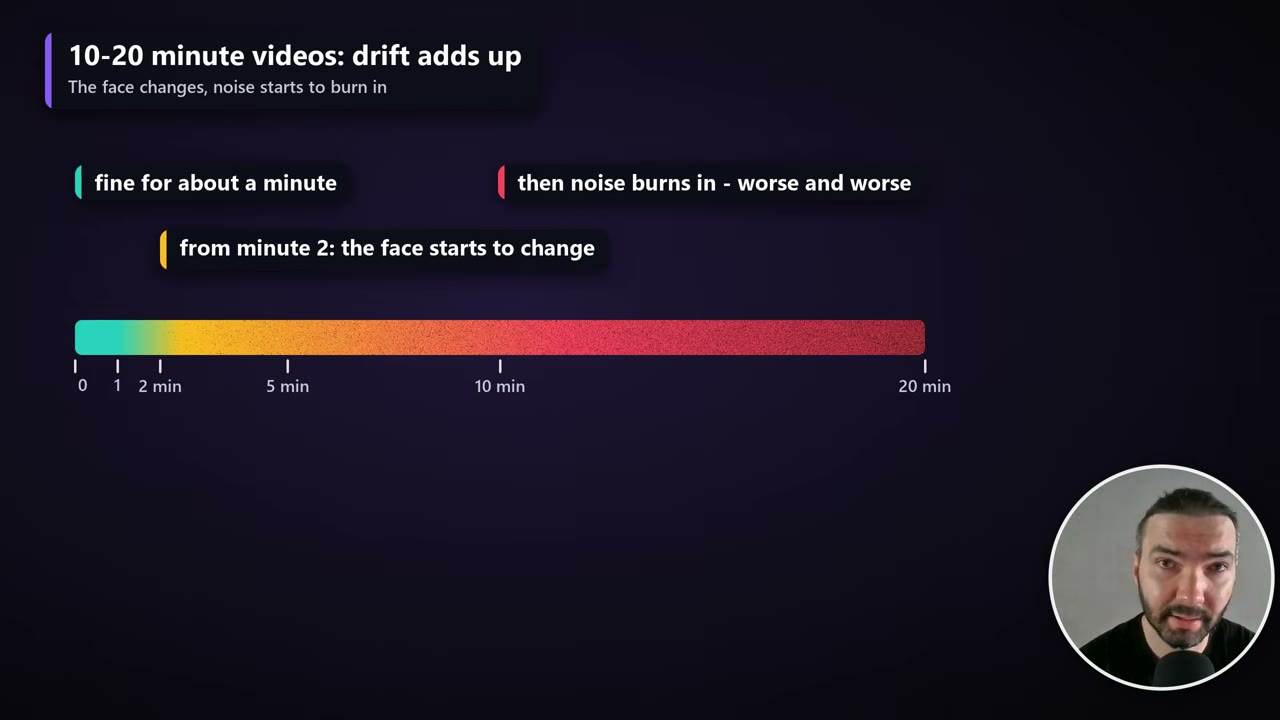
Por isso os fluxos forçam um reinício a partir do retrato original a cada 40–60 segundos. Os reinícios são planejados a partir da locução inteira antes de o render começar, e cada um cai no meio de uma pausa real (pelo menos 0,4 segundo de quase silêncio), então a boca está fechada dos dois lados do corte. Parece um pouco um corte rápido de volta para o retrato.
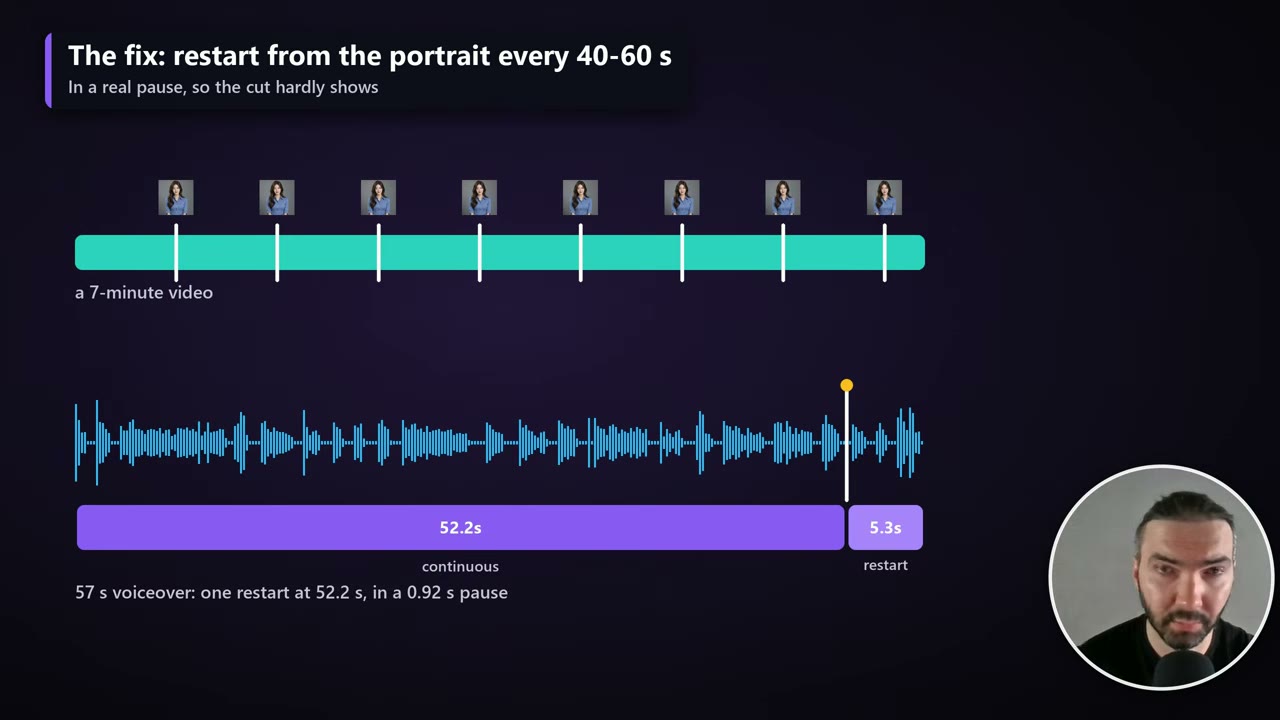
O plano é impresso no log e salvo como output/longcat_longform/<name>/restart_plan.txt.
Renderize
Enfileire o fluxo e acompanhe o console. Carregar o modelo leva alguns minutos toda vez, então o primeiro trecho é o lento. Depois disso são alguns minutos por trecho de 3 segundos, e é assim que um minuto de vídeo acaba levando cerca de uma hora.
Cada item da fila renderiza o próximo trecho inacabado. O README do template diz para definir o batch count em pelo menos a duração da locução em segundos ÷ 3,2, mais uma margem; os itens excedentes são pulados em milissegundos.
- Os trechos são salvos em
output/longcat_longform/<voiceover name>/. - Se o trabalho for interrompido, enfileire de novo e ele continua do último trecho pronto.
- Quando terminar, o vídeo completo é montado em
ComfyUI/output/. Clique com o botão direito nele no JupyterLab para baixar.
A única configuração que vale mudar
Os fluxos têm muitas notas e funcionam como estão; não recomendo mudar muita coisa. A exceção é o espaçamento dos reinícios: restart_min_seconds e restart_max_seconds no nó Split (40 e 60 por padrão).
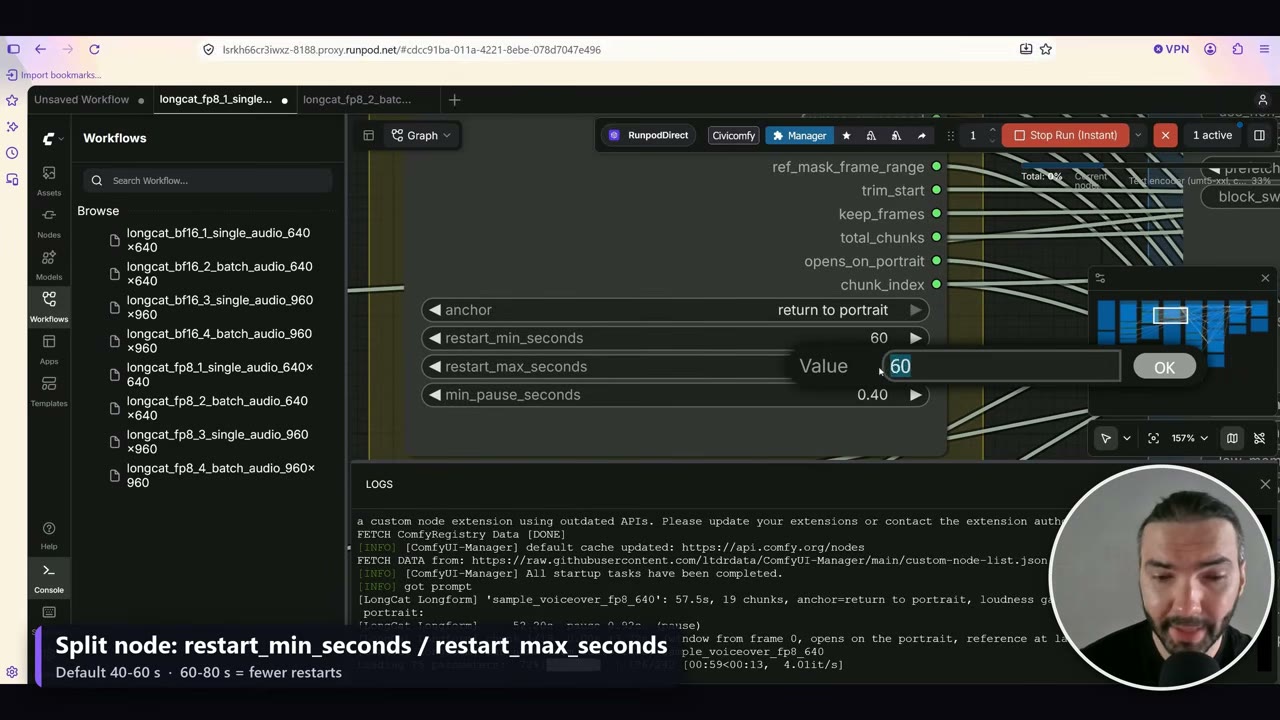
Com 60–80 segundos, o fluxo procura uma pausa nesse intervalo, então há menos cortes de volta para o retrato.
Quando terminar
Pare o pod quando o render terminar. Seus modelos, entradas e saídas ficam no volume. Quando o projeto terminar, exclua também o volume, ou ele continua cobrando.
Erros a evitar
- Escolher a GPU só pela VRAM. A RTX PRO 4500 comum tem 32 GB de VRAM, mas só 30 GB de RAM; escolha a versão SE ou uma 5090.
- Usar BF16 em uma placa de 32 GB. BF16 é para GPUs de 80 GB; use os fluxos FP8 em placas menores.
- Um retrato sem mãos quando você quer movimento das mãos.
- Ir direto para um trabalho longo. Confira no primeiro trecho a sincronização labial, o rosto e o fundo.
- Esquecer o volume. Um pod parado custa pouco; o armazenamento cobra todo mês.
Cadastre-se pelo meu link de indicação do RunPod e você recebe de US$ 5 a US$ 500 em créditos no RunPod. Sem um link de indicação, não há bônus. Eu recebo o mesmo bônus e uso em computação.
Assista à versão em vídeo (10:27)
Tudo o que está acima também está no vídeo, se você preferir acompanhar na tela. O vídeo está em inglês.
Perguntas frequentes
Quanto custa um minuto de vídeo de avatar falante com o LongCat?
Nas minhas execuções (preços de outubro de 2026): cerca de US$ 4,02 em uma H100 SXM em 960 × 960 com o modelo BF16, cerca de US$ 1,97 em uma RTX PRO 4500 em 960 × 960 com FP8 e cerca de US$ 1,03 em uma RTX PRO 4500 em 640 × 640 com FP8.
Quanto tempo o LongCat leva para renderizar um minuto de vídeo?
Cerca de uma hora em uma H100, cerca de 2,7 horas em uma RTX PRO 4500 em 960 × 960 e cerca de 1,4 hora em uma RTX PRO 4500 em 640 × 640.
Quanta VRAM e RAM o LongCat precisa?
Pelo menos 32 GB de VRAM com o modelo FP8, mais 60 GB ou mais de RAM do sistema. Com apenas 30 GB de RAM, o modelo é recarregado a cada trecho, o que é muito mais lento e pode travar o render por completo.
Por que o vídeo volta para o retrato mais ou menos a cada minuto?
O LongCat continua cada trecho a partir do anterior, o que fica contínuo, mas se desvia em vídeos longos. Os fluxos reiniciam a partir do retrato a cada 40–60 segundos, no meio de uma pausa real, para manter o rosto fiel.
Posso rodar o LongCat localmente em vez de no RunPod?
Sim, se você tiver a GPU e a RAM. Está tudo no GitHub; peça ao Claude ou a outra IA para baixar os arquivos e instalá-los na ordem do setup.sh.
Anton Tenitsky é artista 3D com mais de 15 anos em computação gráfica, que trabalhou com Nickelodeon, Gameloft, Marvel Rivals e muitos outros clientes. Mais sobre mim