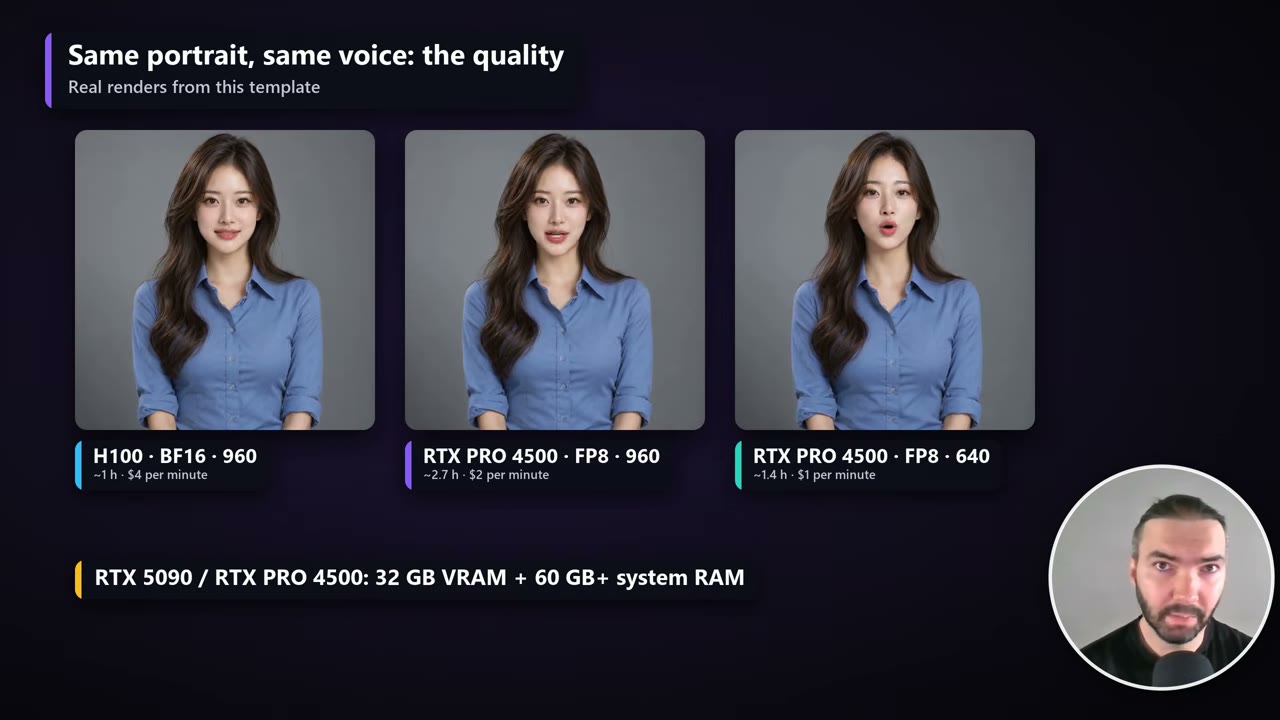
Statut: Testé sur RunPod. J'ai fait des rendus avec ce template sur RunPod, sur une H100 SXM et une RTX PRO 4500. Les temps et les coûts de ce guide viennent de ces exécutions.
Ce sont les avatars parlants de la plus haute qualité que j’aie rendus jusqu’ici. LongCat-Video-Avatar 1.5 est un modèle à poids ouverts de Meituan, entraîné spécifiquement sur des personnes qui parlent, et non sur de la vidéo généraliste. Donnez-lui un portrait et une voix off de n’importe quelle durée, et il renvoie une vidéo synchronisée sur les lèvres avec votre audio d’origine, y compris en cadrage à mi-corps avec mouvements des mains.
La qualité a un prix : c’est un modèle lourd, et il rend lentement. Ce guide présente le template que j’ai construit pour lui, comment le mettre en place sur RunPod, quel GPU choisir (la RAM système compte autant que la VRAM) et ce que coûte vraiment une minute terminée.
En bref
- Coût par minute terminée : environ 4 $ sur une H100, 2 $ sur une RTX PRO 4500 en 960 × 960, 1 $ en 640 × 640 (prix d’octobre 2026).
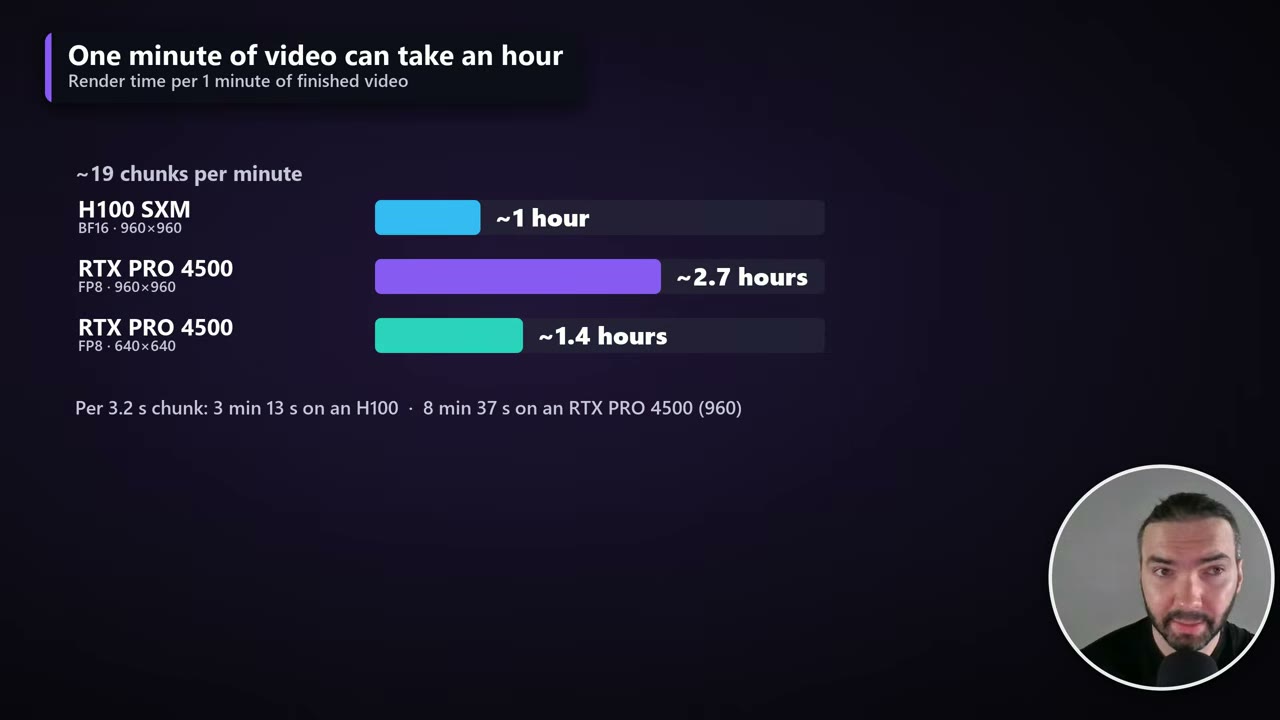
- Temps de rendu par minute terminée : environ 1 heure sur une H100, 1,4 à 2,7 heures sur une RTX PRO 4500.
- Matériel : au moins 32 Go de VRAM et 60 Go+ de RAM système.
- Fonctionnement : des fenêtres de 3,7 secondes, chacune prolongeant la précédente, donc pas de remise à zéro à chaque raccord. Un redémarrage depuis le portrait toutes les 40 à 60 secondes, dans une pause, empêche le visage de dériver.
- Template gratuit sur GitHub, ou en un clic sur RunPod.
Ce que ça coûte
Voici mes mesures sur RunPod en octobre 2026, pour une minute de vidéo terminée :
| GPU | Modèle, canevas | Prix | Temps de rendu par minute | Coût par minute |
|---|---|---|---|---|
| H100 SXM | BF16, 960 × 960 | 4,00 $/h | ~1 heure | ~4,02 $ |
| RTX PRO 4500 | FP8, 960 × 960 | 0,72 $/h | ~2,7 heures | ~1,97 $ |
| RTX PRO 4500 | FP8, 640 × 640 | 0,72 $/h | ~1,4 heure | ~1,03 $ |
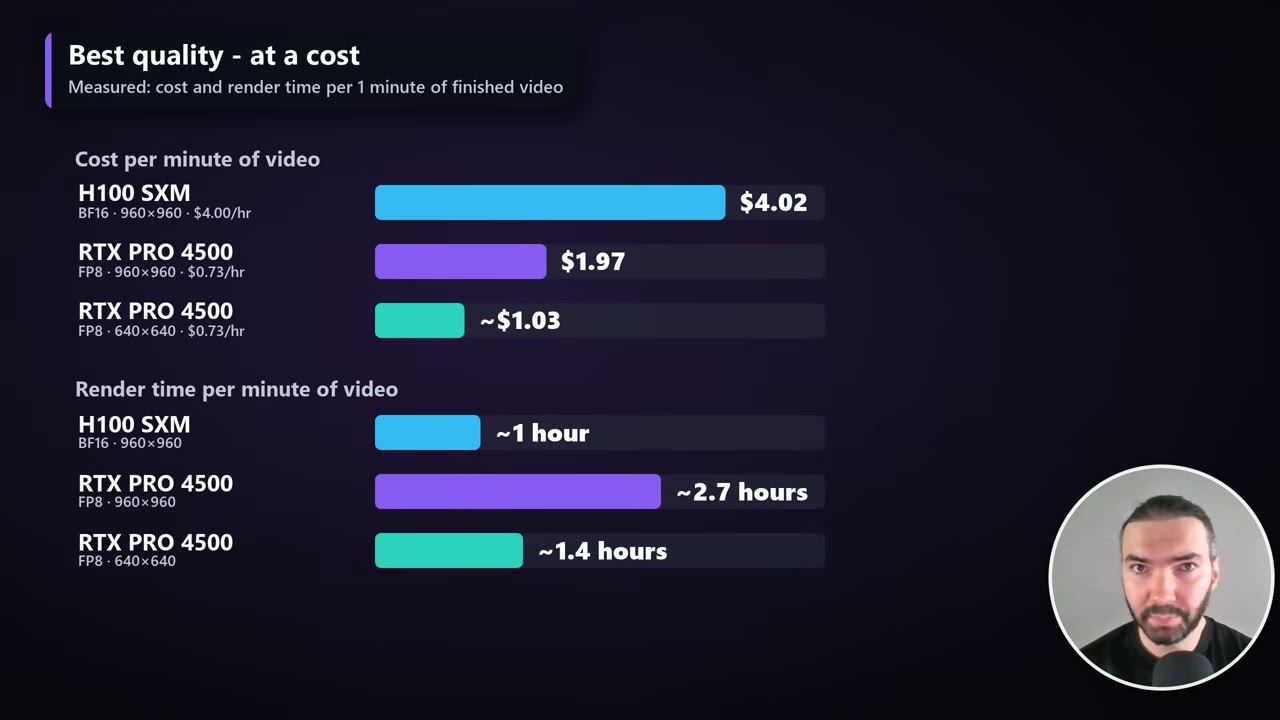
Une minute de vidéo représente environ 19 segments. Un segment de 3,2 secondes a pris environ 3 minutes 13 secondes sur la H100 et environ 8 minutes 37 secondes sur la RTX PRO 4500 en 960 × 960.
La qualité : BF16 contre FP8, 960 contre 640
Le template fournit deux versions du modèle. BF16 est le modèle en pleine précision pour les GPU de 80 Go comme la H100. FP8 est une copie plus légère pour les cartes de 32 à 48 Go comme la RTX 5090 ou la RTX PRO 4500. Les voici côte à côte :
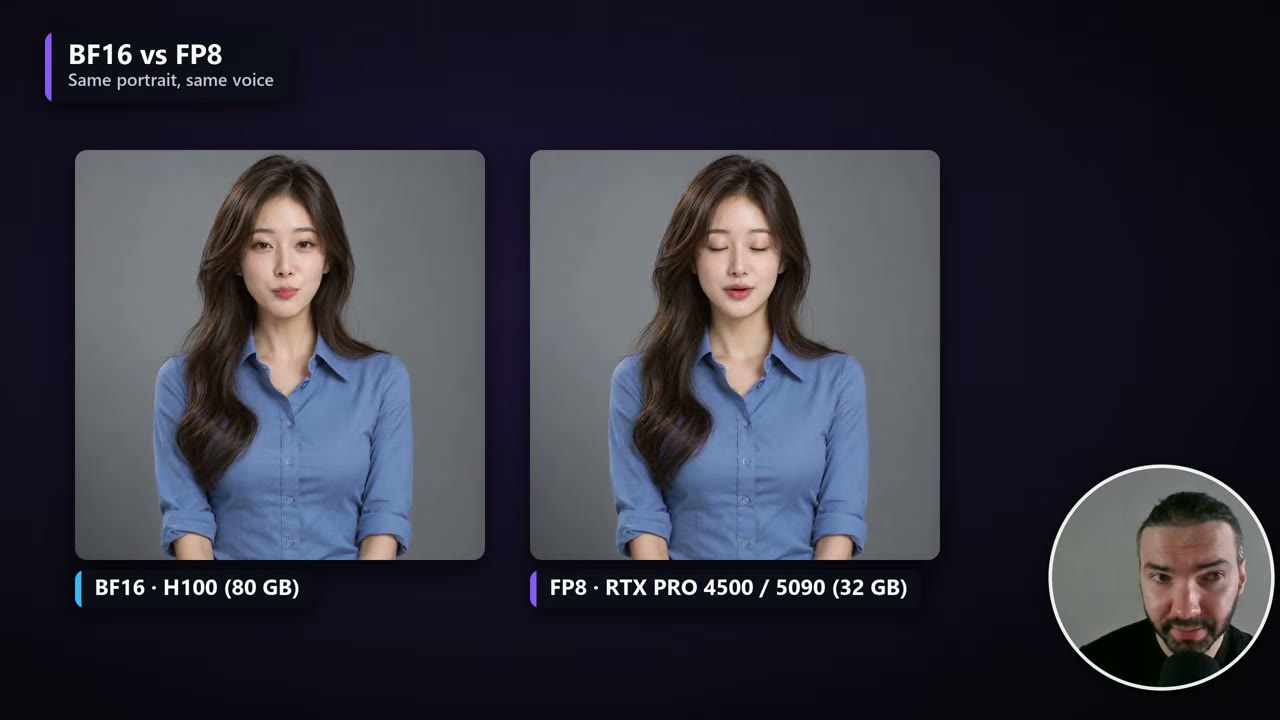
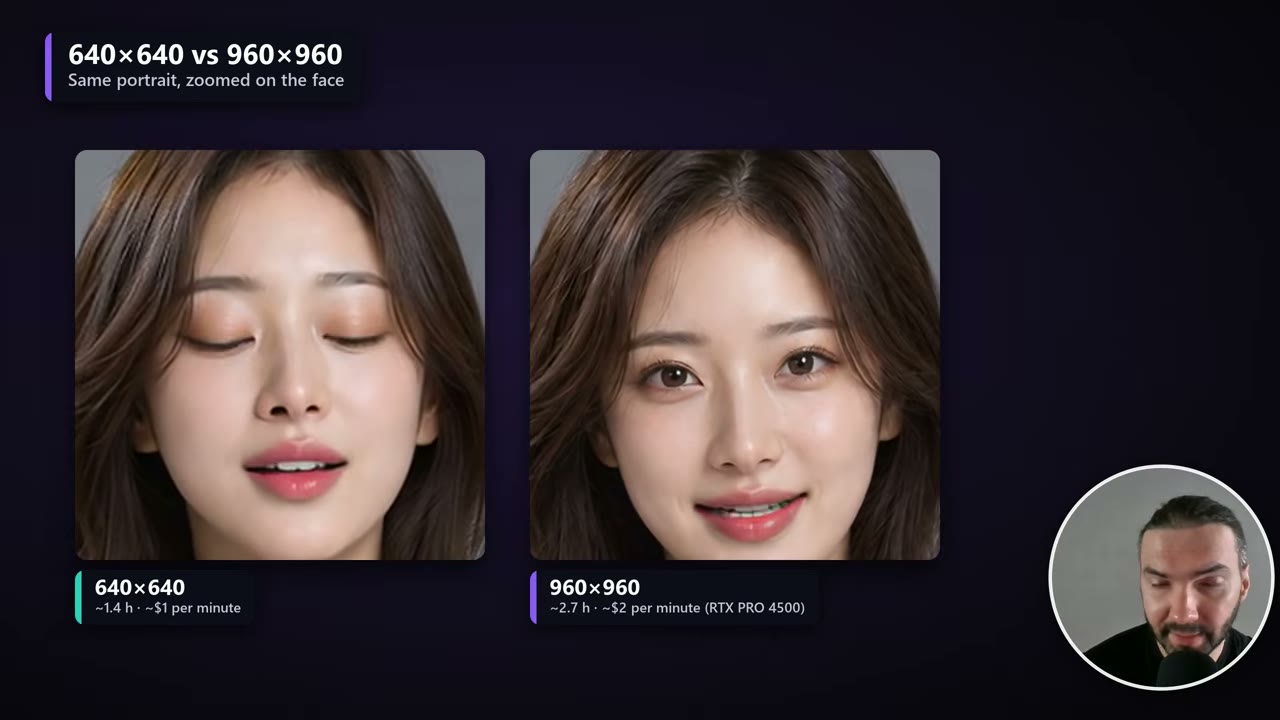
La taille du canevas fait une plus grande différence. Le 960 × 960 est visiblement meilleur que le 640 × 640, et beaucoup plus lent : à vous de juger si le surcoût en vaut la peine.
Deux façons de le faire tourner
Tout est gratuit sur GitHub : les workflows, les custom nodes et le script d’installation.
- Sur RunPod : le template en un clic met tout en place. C’est ce que couvre la suite du guide.
- En local dans ComfyUI : si vous avez le matériel, demandez à Claude (ou à n’importe quelle IA) de récupérer les fichiers sur GitHub et de les installer dans l’ordre de
setup.sh. ComfyUI n’a pas de nodes LongCat natifs ; le modèle passe par ComfyUI-WanVideoWrapper de kijai, que le script installe à un commit figé.
Si vous n’avez jamais utilisé RunPod, mon introduction à RunPod détaille les comptes, le stockage et les pods.
Stockage : volume global ou volume réseau
RunPod propose maintenant deux types de stockage persistant, et le template fonctionne avec les deux. Pour celui-ci, je suis passé à un volume global.
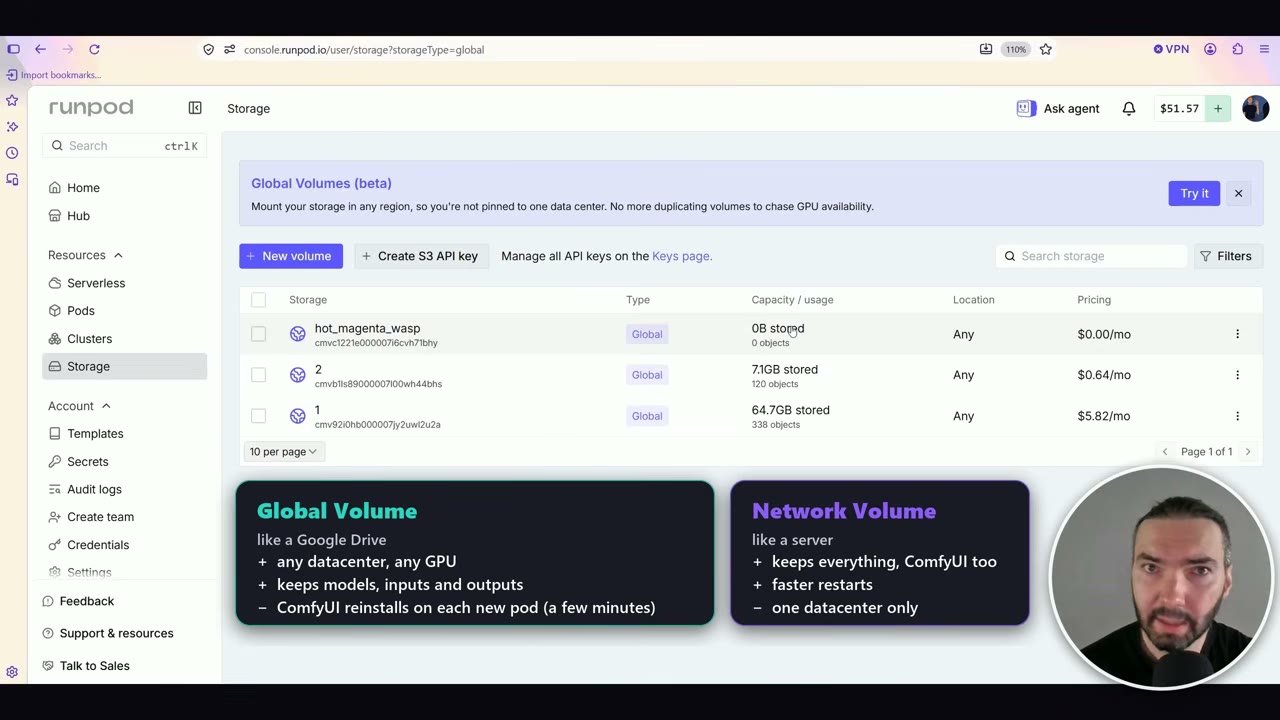
| Volume global | Volume réseau | |
|---|---|---|
| Ce qu’il conserve | Modèles, entrées et sorties | Tout, y compris l’installation de ComfyUI |
| Où l’utiliser | N’importe quel centre de données, donc bien plus de GPU au choix | Un seul centre de données |
| Temps de redémarrage | Quelques minutes de plus : ComfyUI est réinstallé sur chaque nouveau pod | Plus rapide |
| Prix (octobre 2026) | 0,09 $/Go par mois, seulement pour ce qui est stocké | 0,07 $/Go par mois pour la taille réservée, vide ou non |
Pour moi, le facteur décisif est la disponibilité. Avec un volume réseau, vous êtes lié à un seul centre de données, et ce centre de données n’a souvent aucun GPU libre. Un volume global peut s’attacher à un GPU n’importe où.
C’est aussi moins cher pour moi, parce que vous ne payez que ce qui est réellement stocké, facturé à l’heure. Mon volume LongCat contient 64,7 Go, ce qui revient à 5,82 $ par mois. Supprimez-le à tout moment et la facturation s’arrête.
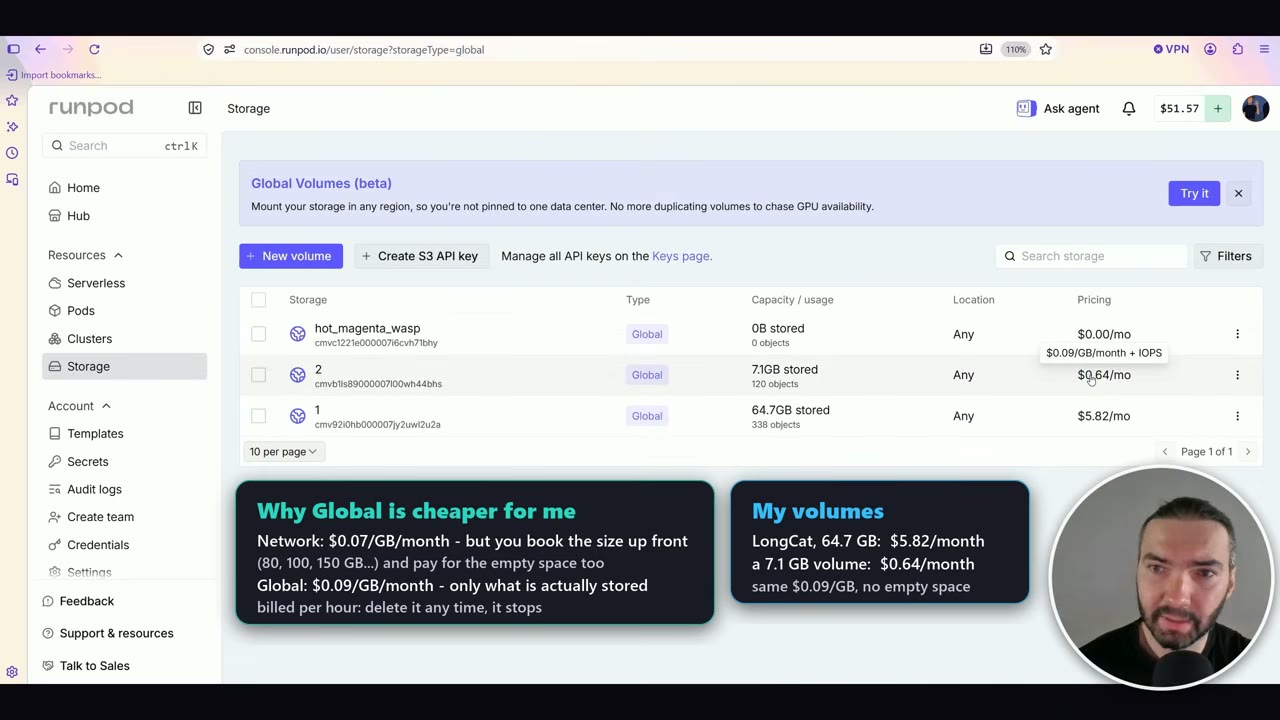
Les volumes globaux sont encore en bêta. Une chose à savoir, tirée de la documentation de RunPod : si le solde de votre compte atteint 0 $, un volume global est signalé puis définitivement supprimé au bout de 15 jours.
Pour le mettre en place : ouvrez le lien du template, allez dans Storage → New volume, choisissez Global volume, créez-le, puis sélectionnez-le et cliquez sur Configure Pod with volume. La page de déploiement n’affiche encore nulle part « Global », mais le volume est bien attaché.
Quel GPU : VRAM et RAM système
LongCat a besoin d’au moins 32 Go de VRAM avec le modèle FP8, et de plus de 60 Go de RAM système. C’est la RAM, le piège.
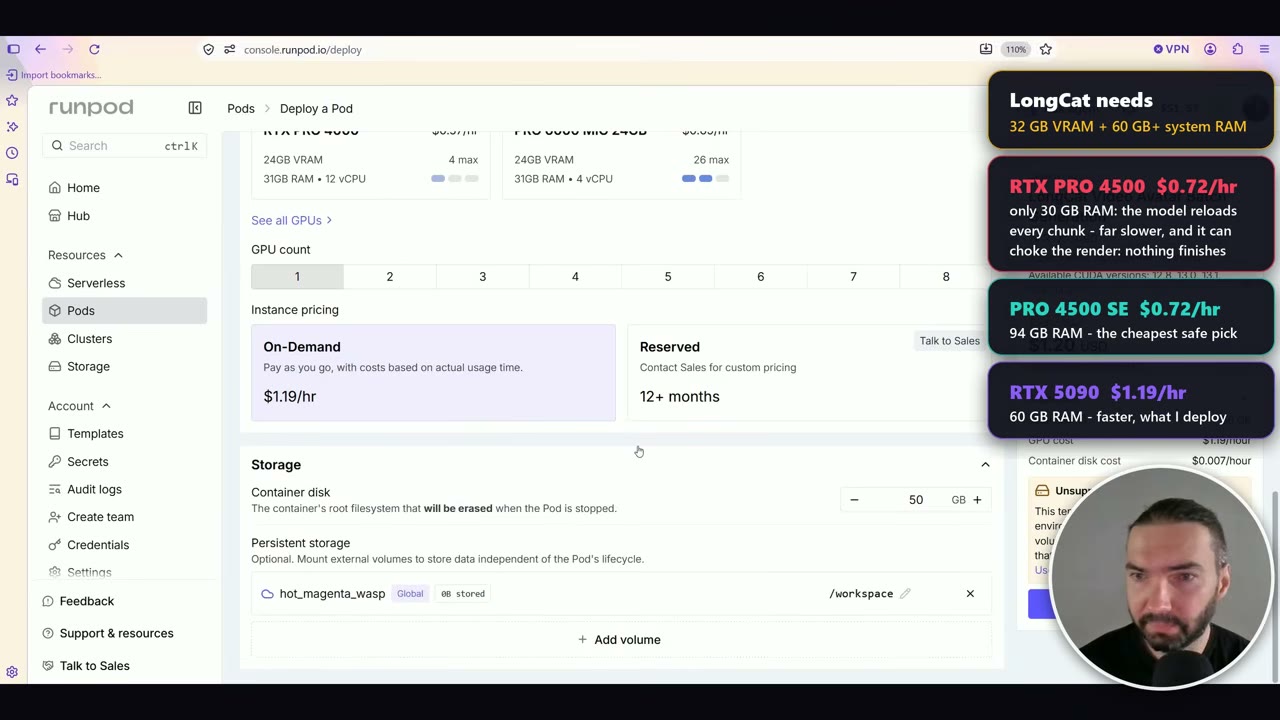
| GPU | VRAM | RAM système | Prix (oct. 2026) | Remarques |
|---|---|---|---|---|
| RTX PRO 4500 | 32 Go | 30 Go | 0,72 $/h | À éviter : le modèle est rechargé à chaque segment |
| RTX PRO 4500 SE | 32 Go | 94 Go | 0,72 $/h | Le choix sûr le moins cher |
| RTX 5090 | 32 Go | 60 Go | 1,19 $/h | Plus rapide |
| H100 SXM | 80 Go | – | 4,00 $/h | Fait tourner le modèle BF16 complet |
Avec seulement 30 Go de RAM, le modèle doit être rechargé à chaque segment. Le rendu devient bien plus lent, et il peut se bloquer complètement.
Déploiement et premier démarrage
- Déployez le pod. Vous verrez peut-être un avertissement « Unsupported volume type » sur la page de déploiement. Avec ce template, vous pouvez l’ignorer sans risque.
- S’il indique qu’il n’y a pas de ressources, cliquez à nouveau sur Deploy. Il faut parfois un second essai à RunPod.
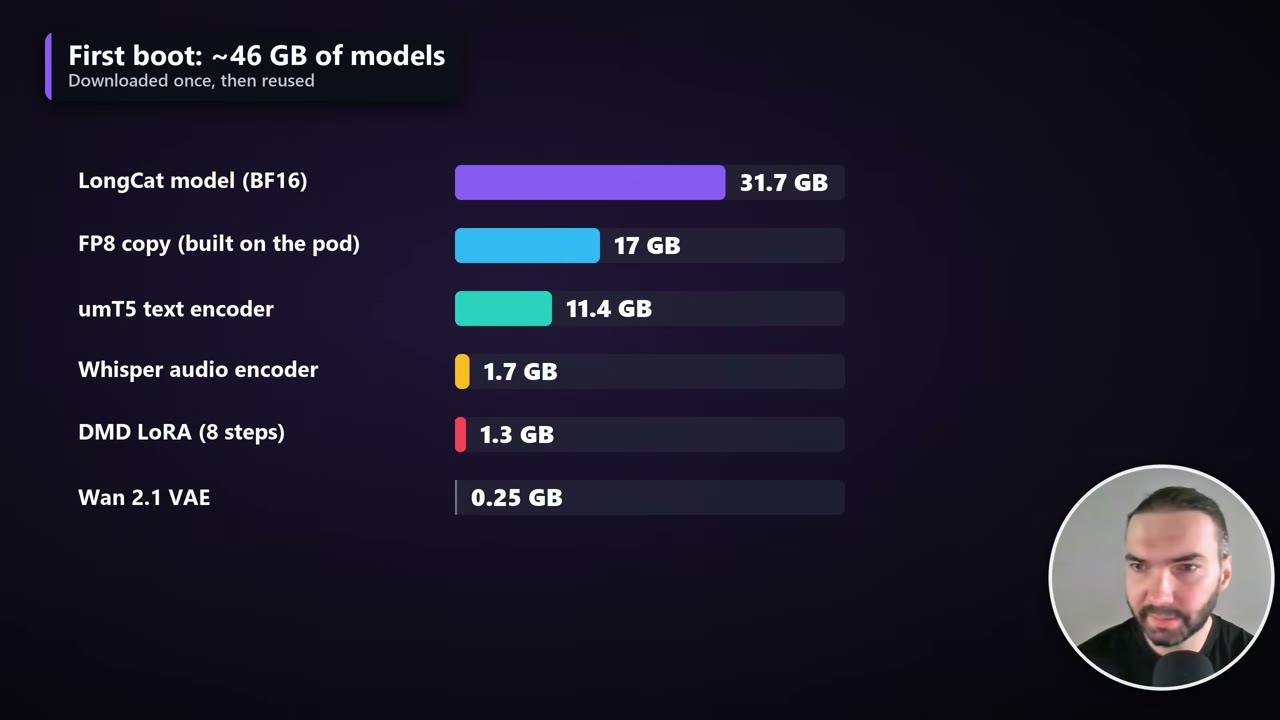
- Attendez les téléchargements. Le premier démarrage télécharge environ 46 Go de modèles, une seule fois. Le pod construit aussi la copie FP8 du modèle à partir du fichier BF16, si bien que les modèles occupent environ 63 Go au total. Les démarrages suivants les réutilisent.
- Si tout est téléchargé mais que ComfyUI ne démarre pas, arrêtez le pod et relancez-le. C’est ce qui m’est arrivé pendant l’enregistrement.
- Ouvrez ComfyUI et JupyterLab depuis le menu Connect du pod. JupyterLab peut continuer d’afficher « initializing » alors qu’il est prêt ; essayez donc de l’ouvrir.
Les workflows
Ouvrez ComfyUI, puis la barre latérale Workflows. Il y a huit workflows : BF16 ou FP8, 640 × 640 ou 960 × 960, et pour chacun une version pour une seule voix off ou par lot.
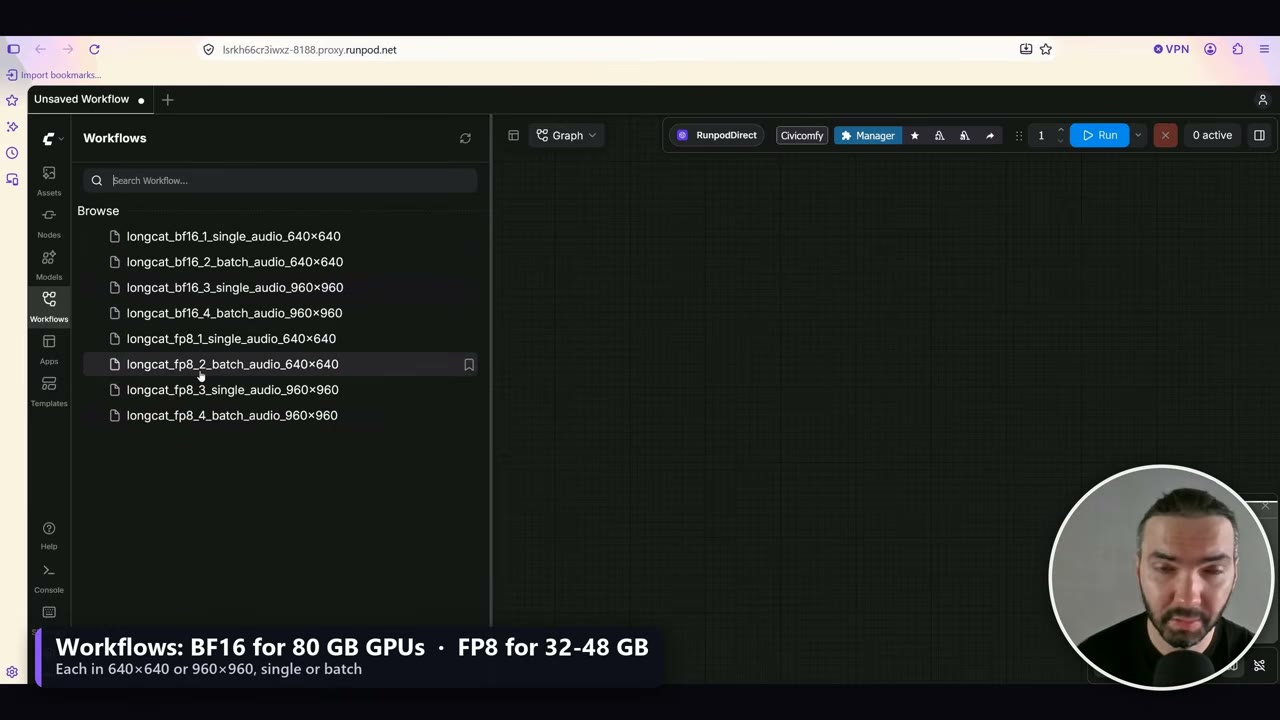
- Single audio rend une voix off. Il s’ouvre sur un portrait d’exemple et une voix off d’exemple d’environ une minute, pour que vous puissiez le tester tout de suite.
- Batch audio rend chaque voix off de
ComfyUI/input/batch_audio/, une vidéo chacune, l’une après l’autre, avec le même portrait.
Envoyez vos propres portraits et voix off avec JupyterLab : les portraits dans ComfyUI/input/, les voix off du lot dans ComfyUI/input/batch_audio/.
Le prompt est facultatif. Pour un avatar parlant normal, laissez-le vide. Vous pouvez demander quelque chose de précis, comme « natural hand movement ».
Gardez les mains dans le portrait
LongCat sait bien animer les mains. Mais si les mains ne figurent pas dans votre portrait, le modèle doit les inventer quand elles entrent dans le cadre, et il n’invente pas toujours les mêmes.
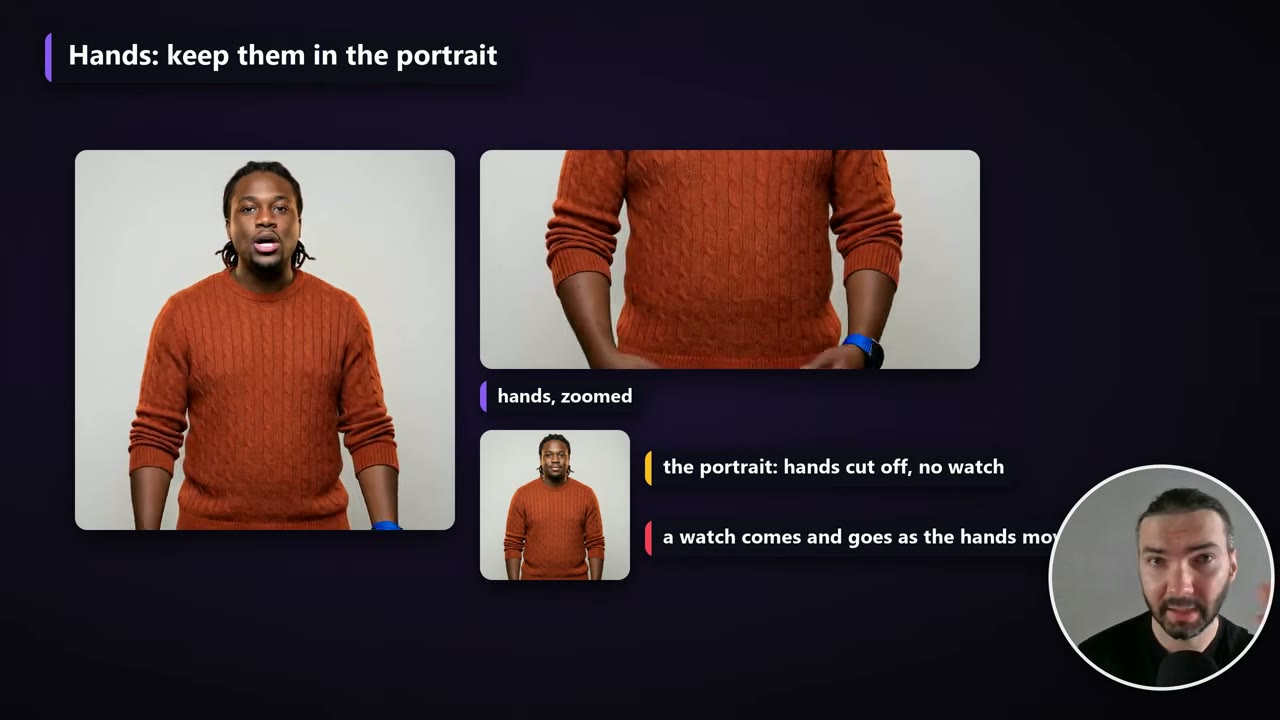
Si vous voulez des mouvements de mains, utilisez un portrait où les mains sont visibles, pour que le modèle sache que les mains d’origine ne portaient pas de montre. Ce n’est toujours pas une garantie, mais cela réduit le risque.
Comment LongCat évite la dérive sur les longues vidéos
Tous les modèles d’avatar rendent par segments : aucun ne rend une minute entière d’un seul coup. Les fenêtres de LongCat durent 3,7 secondes, et c’est là qu’il se distingue des autres.
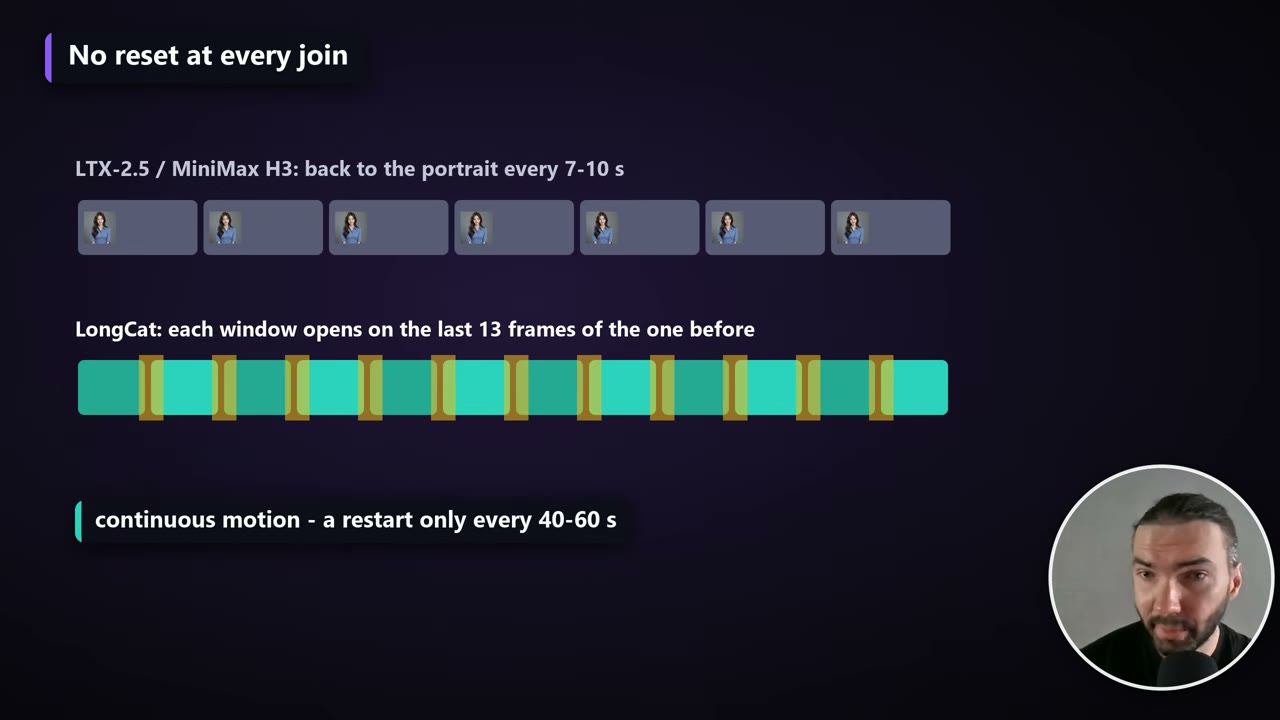
Avec mes templates LTX-2.5 et MiniMax H3, chaque segment revient au portrait d’origine. LongCat ouvre chaque fenêtre sur les 13 dernières images de la précédente, si bien que le mouvement est continu et que les raccords sont invisibles. La synchronisation labiale tient aussi d’un segment à l’autre.
La continuité a toutefois son propre problème. Elle reste stable pendant environ 40 à 70 secondes ; ensuite, le visage commence à changer et du bruit s’accumule, de pire en pire sur une vidéo de 10 ou 20 minutes.
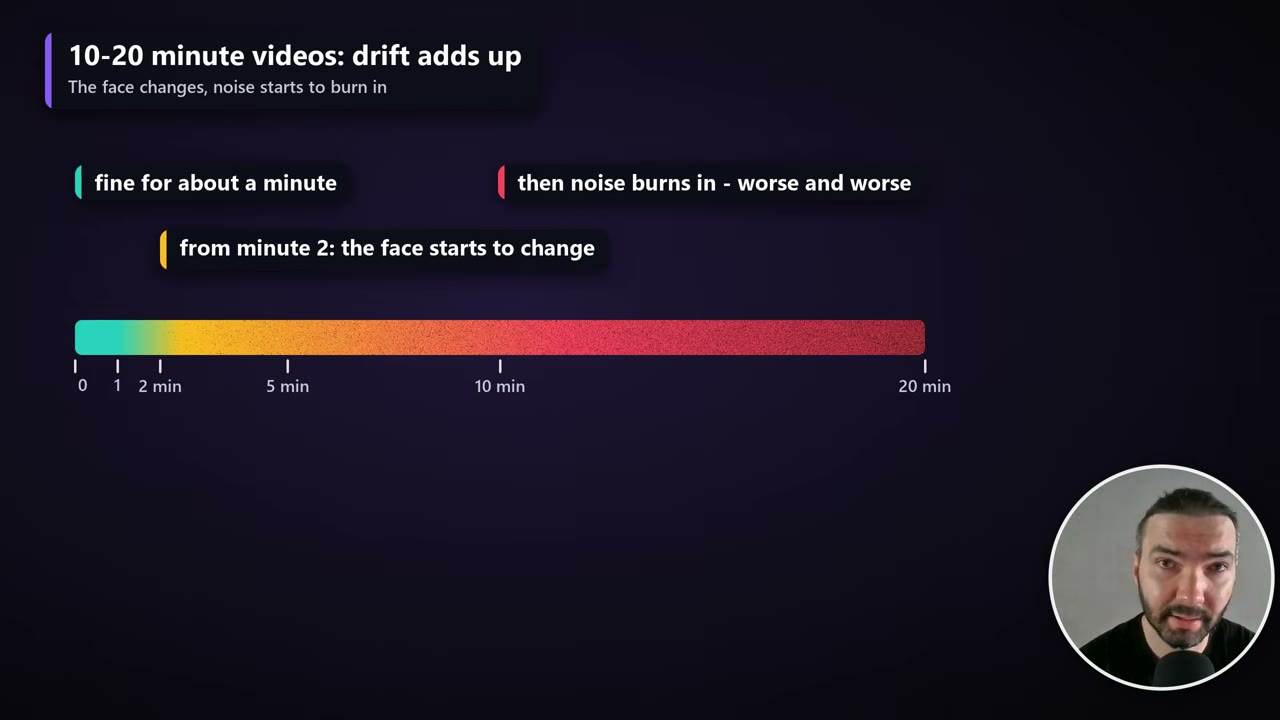
Les workflows forcent donc un redémarrage depuis le portrait d’origine toutes les 40 à 60 secondes. Les redémarrages sont planifiés à partir de la voix off complète avant le début du rendu, et chacun tombe au milieu d’une vraie pause (au moins 0,4 seconde de quasi-silence), pour que la bouche soit fermée des deux côtés de la coupe. Cela ressemble un peu à un cut rapide vers le portrait.
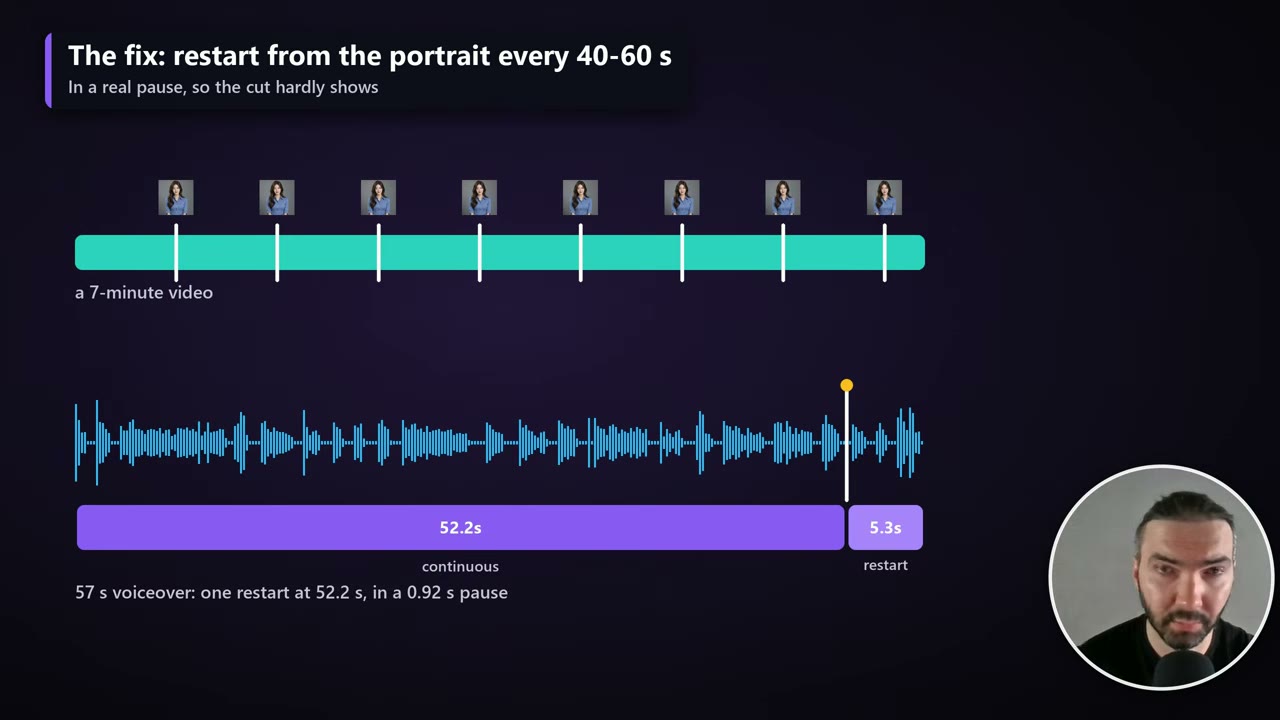
Le plan est affiché dans le log et enregistré sous output/longcat_longform/<name>/restart_plan.txt.
Rendu
Mettez le workflow en file et surveillez la console. Le chargement du modèle prend quelques minutes à chaque fois, c’est donc le premier segment qui est lent. Ensuite, comptez quelques minutes par segment de 3 secondes, et c’est ainsi qu’une minute de vidéo finit par prendre environ une heure.
Chaque élément de la file rend le prochain segment inachevé. Le README du template conseille de régler le nombre de lots sur au moins la durée de la voix off en secondes ÷ 3,2, plus une marge ; les éléments en trop sont ignorés en quelques millisecondes.
- Les segments sont enregistrés dans
output/longcat_longform/<voiceover name>/. - Si la tâche est interrompue, remettez-la en file et elle reprend au dernier segment terminé.
- Une fois terminée, la vidéo complète est assemblée dans
ComfyUI/output/. Clic droit dans JupyterLab pour la télécharger.
Le seul réglage qui vaut la peine d’être modifié
Les workflows contiennent beaucoup de notes, et ils fonctionnent tels quels ; je déconseille d’y changer grand-chose. L’exception est l’espacement des redémarrages : restart_min_seconds et restart_max_seconds sur le node Split (40 et 60 par défaut).
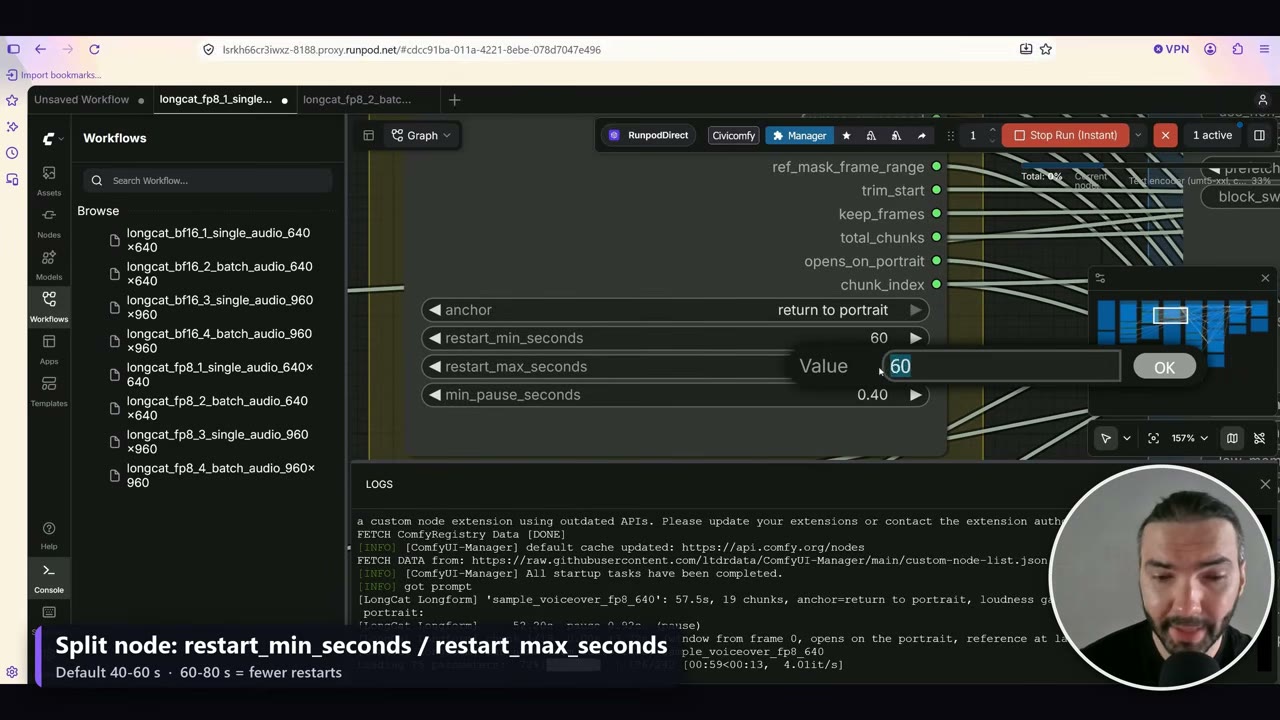
Avec 60 à 80 secondes, le workflow cherche plutôt une pause dans cette plage, ce qui fait moins de retours au portrait.
Quand vous avez fini
Arrêtez le pod quand le rendu est terminé. Vos modèles, entrées et sorties restent sur le volume. Quand le projet est fini, supprimez aussi le volume, sinon il continue d’être facturé.
Les erreurs à éviter
- Choisir un GPU uniquement d’après la VRAM. La RTX PRO 4500 standard a 32 Go de VRAM mais seulement 30 Go de RAM ; prenez la version SE ou une 5090.
- Utiliser BF16 sur une carte de 32 Go. BF16 est pour les GPU de 80 Go ; utilisez les workflows FP8 sur les cartes plus petites.
- Un portrait sans les mains quand vous voulez des mouvements de mains.
- Se lancer directement dans une longue tâche. Vérifiez le premier segment : synchronisation labiale, visage et arrière-plan.
- Oublier le volume. Un pod arrêté coûte peu ; le stockage est facturé chaque mois.
Inscrivez-vous via mon lien de parrainage RunPod et vous recevrez de 5 à 500 $ de crédits RunPod. Sans lien de parrainage, pas de bonus. Je reçois le même bonus et je l'utilise pour du calcul GPU.
Voir la version vidéo (10:27)
Tout ce qui précède est aussi dans la vidéo, si vous préférez suivre à l’écran. La vidéo est en anglais.
Questions fréquentes
Combien coûte une minute de vidéo d'avatar parlant LongCat ?
Dans mes essais (prix d'octobre 2026) : environ 4,02 $ sur une H100 SXM en 960 × 960 avec le modèle BF16, environ 1,97 $ sur une RTX PRO 4500 en 960 × 960 avec FP8, et environ 1,03 $ sur une RTX PRO 4500 en 640 × 640 avec FP8.
Combien de temps LongCat met-il pour rendre une minute de vidéo ?
Environ une heure sur une H100, environ 2,7 heures sur une RTX PRO 4500 en 960 × 960, et environ 1,4 heure sur une RTX PRO 4500 en 640 × 640.
De combien de VRAM et de RAM LongCat a-t-il besoin ?
Au moins 32 Go de VRAM avec le modèle FP8, plus 60 Go ou plus de RAM système. Avec seulement 30 Go de RAM, le modèle est rechargé à chaque segment, ce qui est bien plus lent et peut bloquer complètement le rendu.
Pourquoi la vidéo revient-elle au portrait environ toutes les minutes ?
LongCat prolonge chaque segment à partir du précédent, ce qui paraît sans couture mais dérive sur les longues vidéos. Les workflows repartent du portrait toutes les 40 à 60 secondes, au milieu d'une vraie pause, pour que le visage reste fidèle.
Puis-je faire tourner LongCat en local plutôt que sur RunPod ?
Oui, si vous avez le GPU et la RAM. Tout est sur GitHub ; demandez à Claude ou à une autre IA de récupérer les fichiers et de les installer dans l'ordre de setup.sh.
Anton Tenitsky est artiste 3D avec plus de 15 ans d'expérience en infographie, qui a travaillé avec Nickelodeon, Gameloft, Marvel Rivals et de nombreux autres clients. En savoir plus sur moi