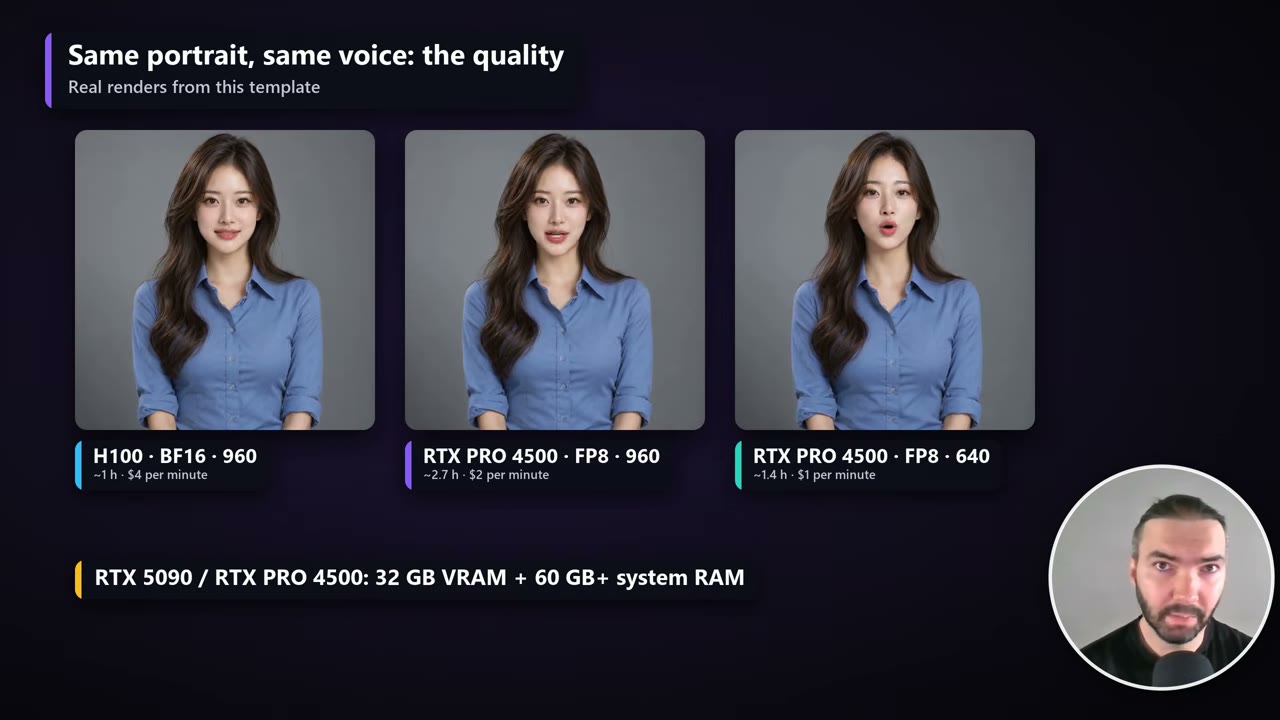
Status: Auf RunPod getestet. Ich habe mit diesem Template auf RunPod auf einer H100 SXM und einer RTX PRO 4500 gerendert. Die Zeiten und Kosten in diesem Leitfaden stammen aus diesen Läufen.
Das sind die hochwertigsten Talking Avatars, die ich bisher gerendert habe. LongCat-Video-Avatar 1.5 ist ein Modell mit offenen Gewichten von Meituan, das gezielt auf sprechende Menschen trainiert wurde, nicht auf allgemeines Video. Gib ihm ein Porträt und ein Voiceover beliebiger Länge, und es liefert ein lippensynchrones Video mit deinem Original-Audio, auch im Halbkörper-Ausschnitt mit Handbewegungen.
Die Qualität hat ihren Preis: Es ist ein schweres Modell, und es rendert langsam. Dieser Leitfaden behandelt das Template, das ich dafür gebaut habe, wie du es auf RunPod einrichtest, welche GPU du wählen solltest (System-RAM zählt genauso viel wie VRAM) und was eine fertige Minute wirklich kostet.
Kurz gefasst
- Kosten pro fertiger Minute: etwa 4 $ auf einer H100, 2 $ auf einer RTX PRO 4500 bei 960 × 960, 1 $ bei 640 × 640 (Preise vom Oktober 2026).
- Renderzeit pro fertiger Minute: etwa 1 Stunde auf einer H100, 1,4–2,7 Stunden auf einer RTX PRO 4500.
- Hardware: mindestens 32 GB VRAM und 60 GB+ System-RAM.
- So funktioniert es: Fenster von 3,7 Sekunden, jedes setzt das vorherige fort, sodass es nicht an jedem Übergang zurückgesetzt wird. Ein Neustart vom Porträt alle 40–60 Sekunden, in einer Pause, verhindert, dass das Gesicht wegdriftet.
- Kostenloses Template auf GitHub oder mit einem Klick auf RunPod.
Was es kostet
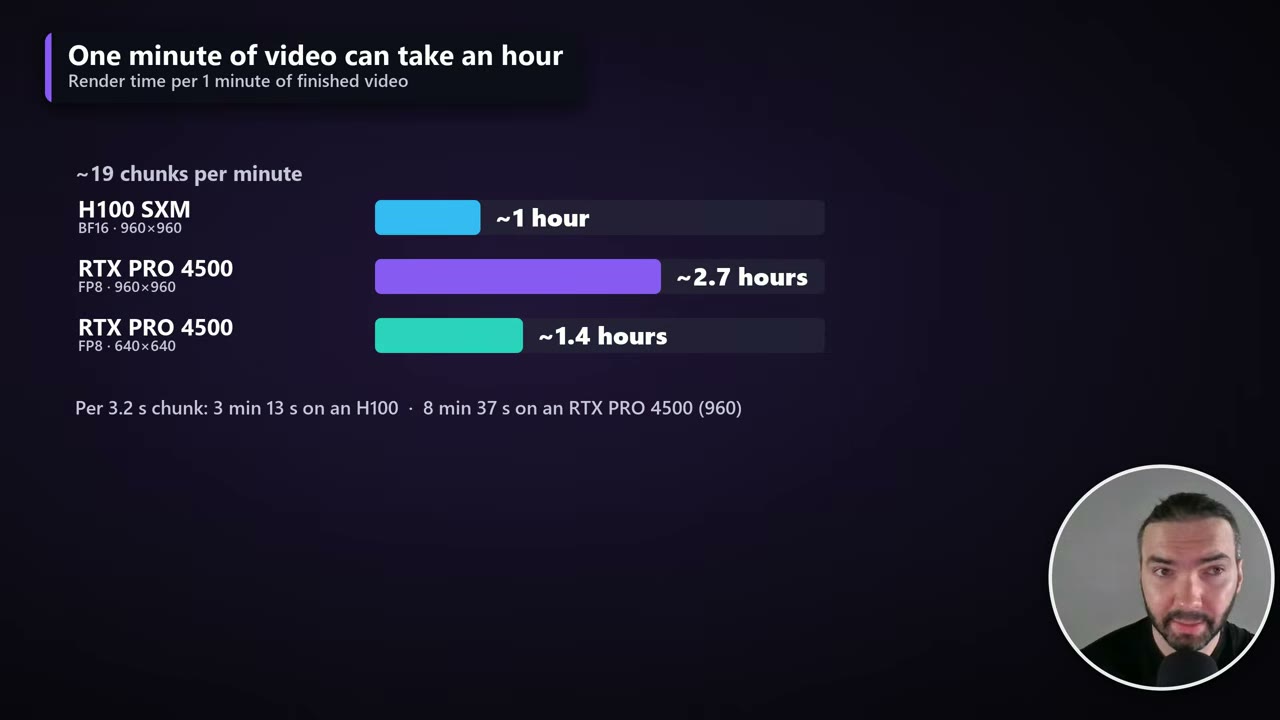
Das sind meine Messungen auf RunPod im Oktober 2026, für eine Minute fertiges Video:
| GPU | Modell, Leinwand | Preis | Renderzeit pro Minute | Kosten pro Minute |
|---|---|---|---|---|
| H100 SXM | BF16, 960 × 960 | 4,00 $/Std. | ~1 Stunde | ~4,02 $ |
| RTX PRO 4500 | FP8, 960 × 960 | 0,72 $/Std. | ~2,7 Stunden | ~1,97 $ |
| RTX PRO 4500 | FP8, 640 × 640 | 0,72 $/Std. | ~1,4 Stunden | ~1,03 $ |
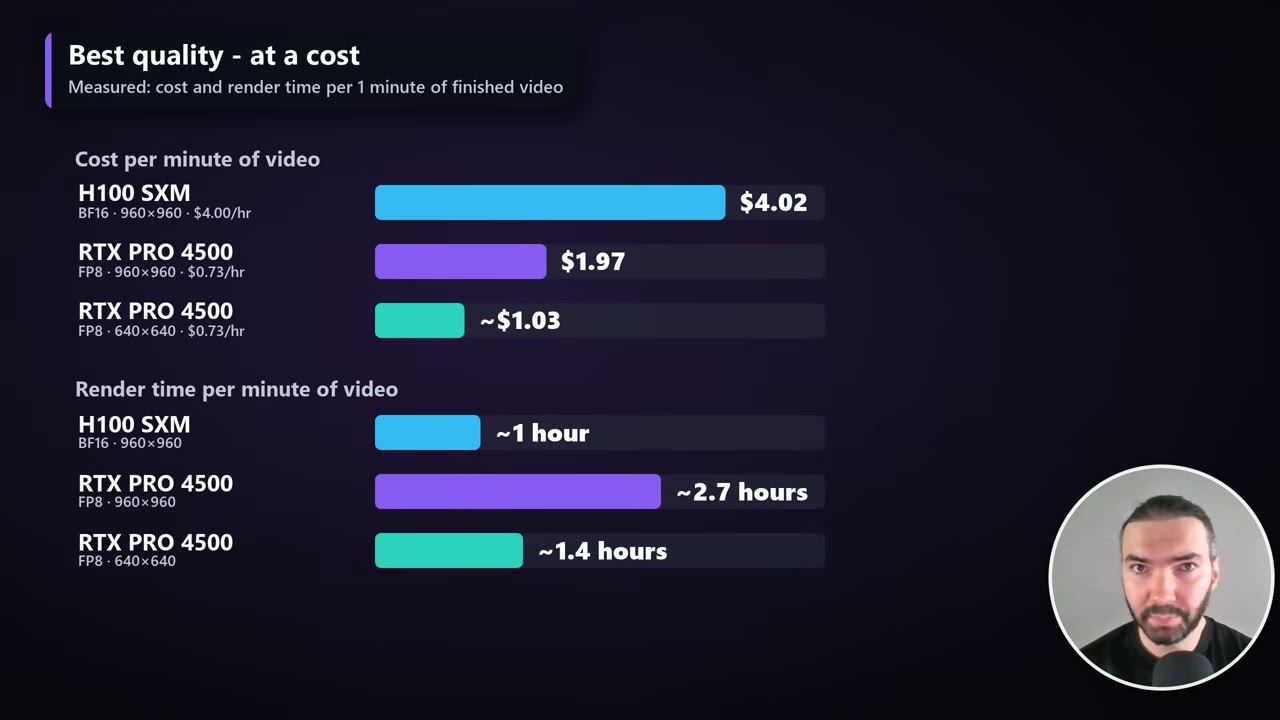
Eine Minute Video sind etwa 19 Abschnitte. Ein Abschnitt von 3,2 Sekunden dauerte auf der H100 etwa 3 Minuten 13 Sekunden und auf der RTX PRO 4500 bei 960 × 960 etwa 8 Minuten 37 Sekunden.
Die Qualität: BF16 gegen FP8, 960 gegen 640
Das Template bringt zwei Versionen des Modells mit. BF16 ist das Modell in voller Präzision für 80-GB-GPUs wie die H100. FP8 ist eine kleinere Kopie für Karten mit 32–48 GB wie die RTX 5090 oder RTX PRO 4500. Hier sind sie nebeneinander:
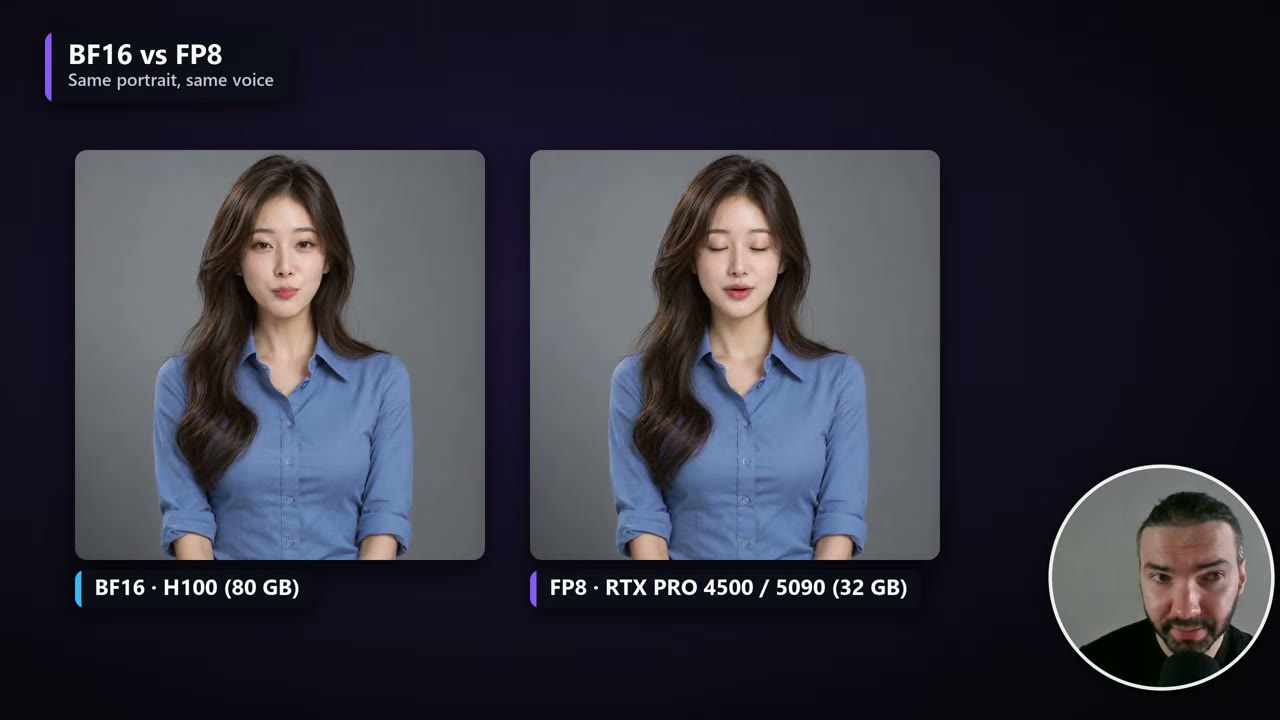
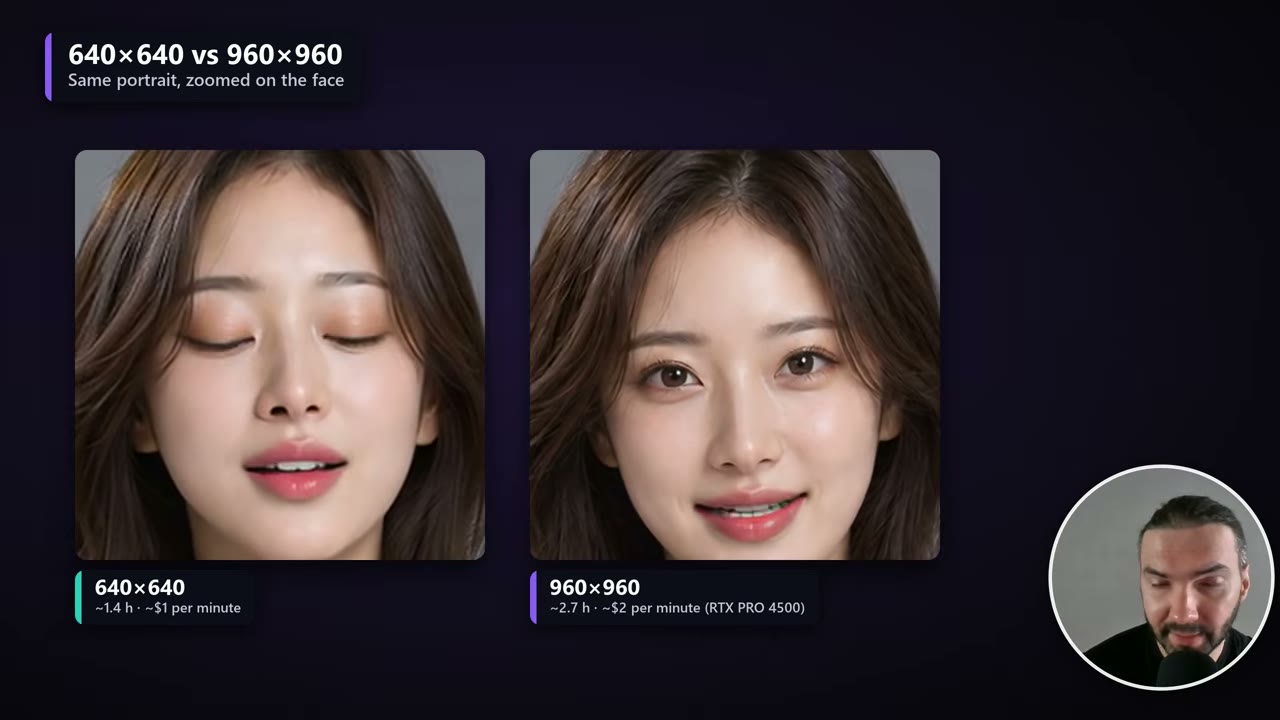
Die Leinwandgröße macht einen größeren Unterschied. 960 × 960 ist sichtbar besser als 640 × 640 und viel langsamer: Ob es die Mehrkosten wert ist, entscheidest du.
Zwei Wege, es auszuführen
Alles ist kostenlos auf GitHub: die Workflows, die Custom Nodes und das Setup-Skript.
- Auf RunPod: Das Ein-Klick-Template richtet alles ein. Darum geht es im Rest des Leitfadens.
- Lokal in ComfyUI: Wenn du die Hardware hast, bitte Claude (oder eine beliebige KI), die Dateien von GitHub zu holen und in der Reihenfolge von
setup.shzu installieren. ComfyUI hat keine nativen LongCat-Nodes; das Modell läuft über kijais ComfyUI-WanVideoWrapper, den das Skript auf einem festgelegten Commit installiert.
Wenn du RunPod noch nicht genutzt hast, behandelt meine Einführung in RunPod Konten, Speicher und Pods.
Speicher: Global Volume oder Network Volume
RunPod hat jetzt zwei Arten von dauerhaftem Speicher, und das Template funktioniert mit beiden. Für dieses Projekt bin ich auf ein Global Volume umgestiegen.
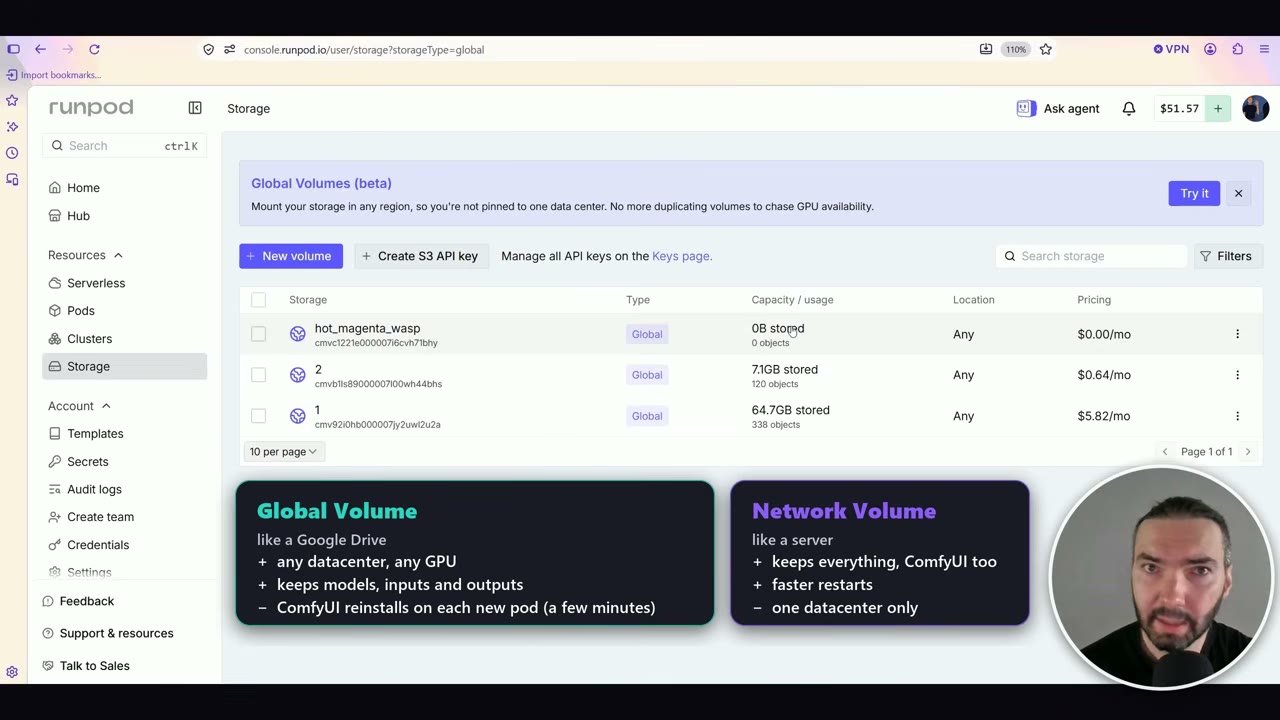
| Global Volume | Network Volume | |
|---|---|---|
| Was es behält | Modelle, Inputs und Outputs | Alles, einschließlich der ComfyUI-Installation |
| Wo du es nutzen kannst | Jedes Rechenzentrum, also viel mehr GPUs zur Auswahl | Nur ein Rechenzentrum |
| Neustartzeit | Ein paar Minuten mehr: ComfyUI wird auf jedem neuen Pod neu installiert | Schneller |
| Preis (Oktober 2026) | 0,09 $/GB im Monat, nur für das, was gespeichert ist | 0,07 $/GB im Monat für die gebuchte Größe, leer oder nicht |
Der entscheidende Faktor ist für mich die Verfügbarkeit. Mit einem Network Volume bist du an ein Rechenzentrum gebunden, und dieses Rechenzentrum hat oft keine freien GPUs. Ein Global Volume lässt sich überall an eine GPU anhängen.
Für mich ist es auch günstiger, weil du nur für das bezahlst, was tatsächlich gespeichert ist, stundenweise abgerechnet. Mein LongCat-Volume enthält 64,7 GB, das macht 5,82 $ im Monat. Lösche es jederzeit, und die Abrechnung endet.
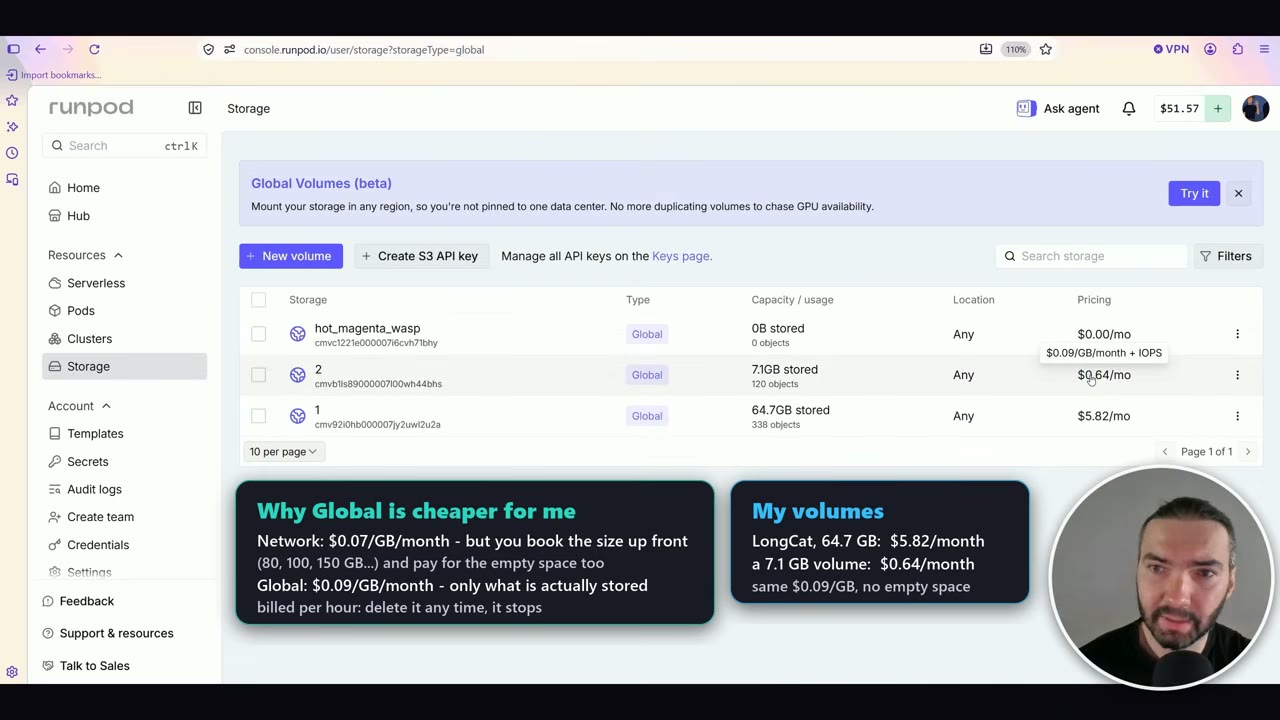
Global Volumes sind noch in der Beta. Eine Sache aus der RunPod-Dokumentation solltest du kennen: Wenn dein Kontoguthaben 0 $ erreicht, wird ein Global Volume markiert und nach 15 Tagen endgültig gelöscht.
So richtest du es ein: Öffne den Template-Link, geh zu Storage → New volume, wähle Global volume, lege es an, wähle es dann aus und klicke auf Configure Pod with volume. Auf der Bereitstellungsseite steht noch nirgends „Global“, aber das Volume ist angehängt.
Welche GPU: VRAM und System-RAM
LongCat braucht mit dem FP8-Modell mindestens 32 GB VRAM und mehr als 60 GB System-RAM. Der RAM ist die Falle.
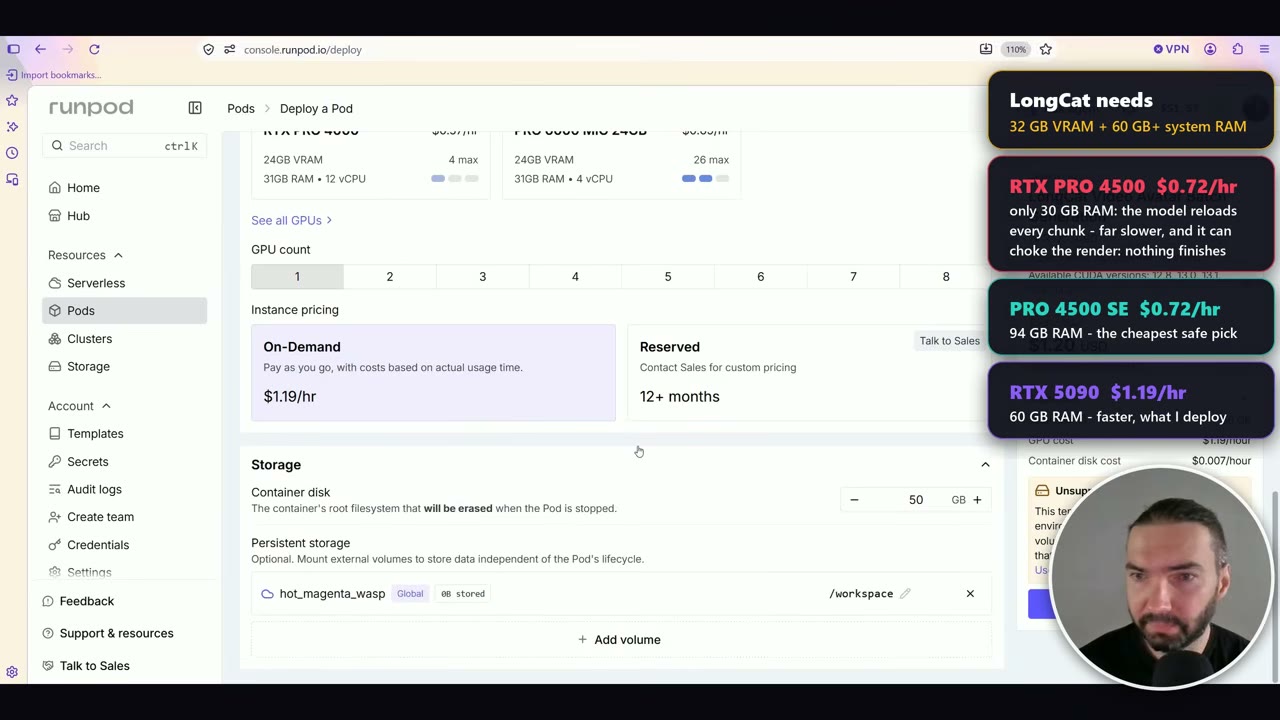
| GPU | VRAM | System-RAM | Preis (Okt. 2026) | Hinweise |
|---|---|---|---|---|
| RTX PRO 4500 | 32 GB | 30 GB | 0,72 $/Std. | Meiden: Das Modell wird für jeden Abschnitt neu geladen |
| RTX PRO 4500 SE | 32 GB | 94 GB | 0,72 $/Std. | Die günstigste sichere Wahl |
| RTX 5090 | 32 GB | 60 GB | 1,19 $/Std. | Schneller |
| H100 SXM | 80 GB | – | 4,00 $/Std. | Führt das volle BF16-Modell aus |
Mit nur 30 GB RAM muss das Modell für jeden Abschnitt neu geladen werden. Das macht den Render viel langsamer und kann ihn komplett zum Stocken bringen.
Bereitstellen und erster Start
- Stelle den Pod bereit. Auf der Bereitstellungsseite siehst du vielleicht die Warnung „Unsupported volume type“. Bei diesem Template kannst du sie getrost ignorieren.
- Wenn es heißt, es seien keine Ressourcen verfügbar, klicke erneut auf Deploy. Manchmal braucht RunPod einen zweiten Versuch.
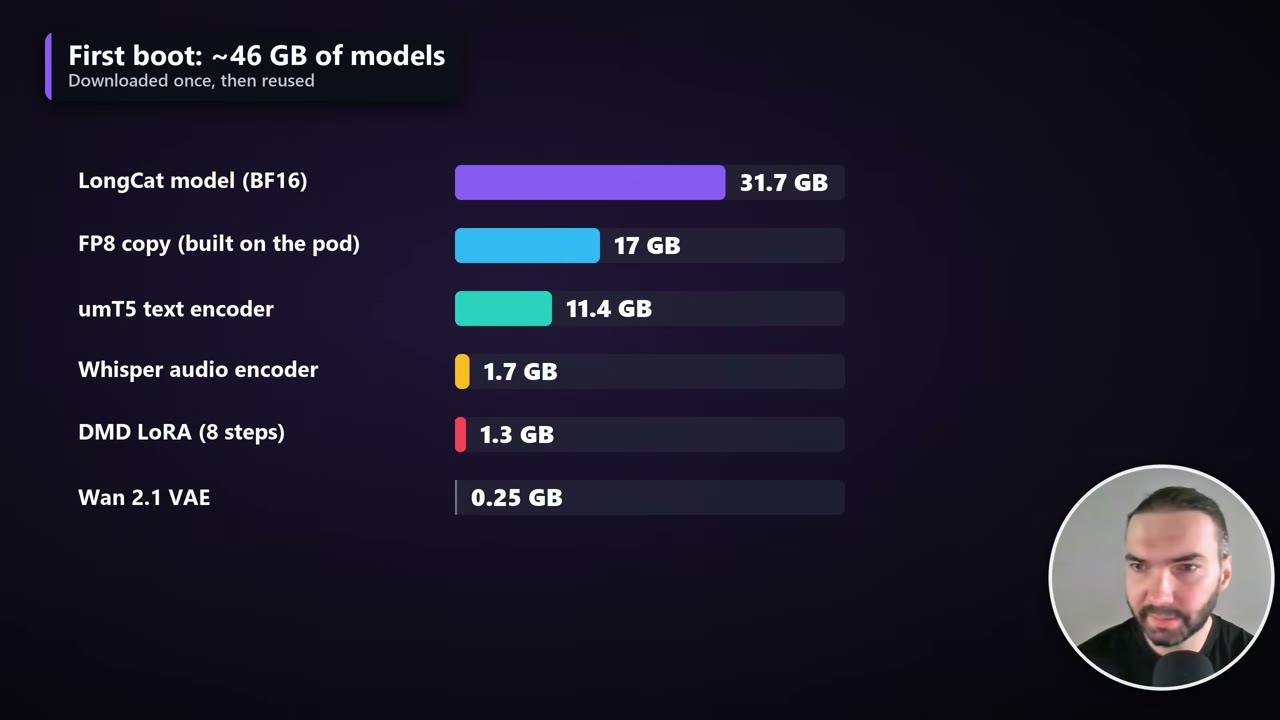
- Warte auf die Downloads. Der erste Start lädt einmalig etwa 46 GB an Modellen herunter. Der Pod erstellt außerdem die FP8-Kopie des Modells aus der BF16-Datei, sodass die Modelle insgesamt etwa 63 GB belegen. Spätere Starts verwenden sie wieder.
- Wenn alles heruntergeladen ist, ComfyUI aber nicht startet, stoppe den Pod und starte ihn neu. Das ist mir während der Aufnahme passiert.
- Öffne ComfyUI und JupyterLab über das Connect-Menü des Pods. JupyterLab kann weiter „initializing“ anzeigen, obwohl es schon bereit ist, also versuche, es zu öffnen.
Die Workflows
Öffne ComfyUI und dann die Workflows-Seitenleiste. Es gibt acht Workflows: BF16 oder FP8, 640 × 640 oder 960 × 960 und jeweils eine Version für ein einzelnes Voiceover oder für einen Batch.
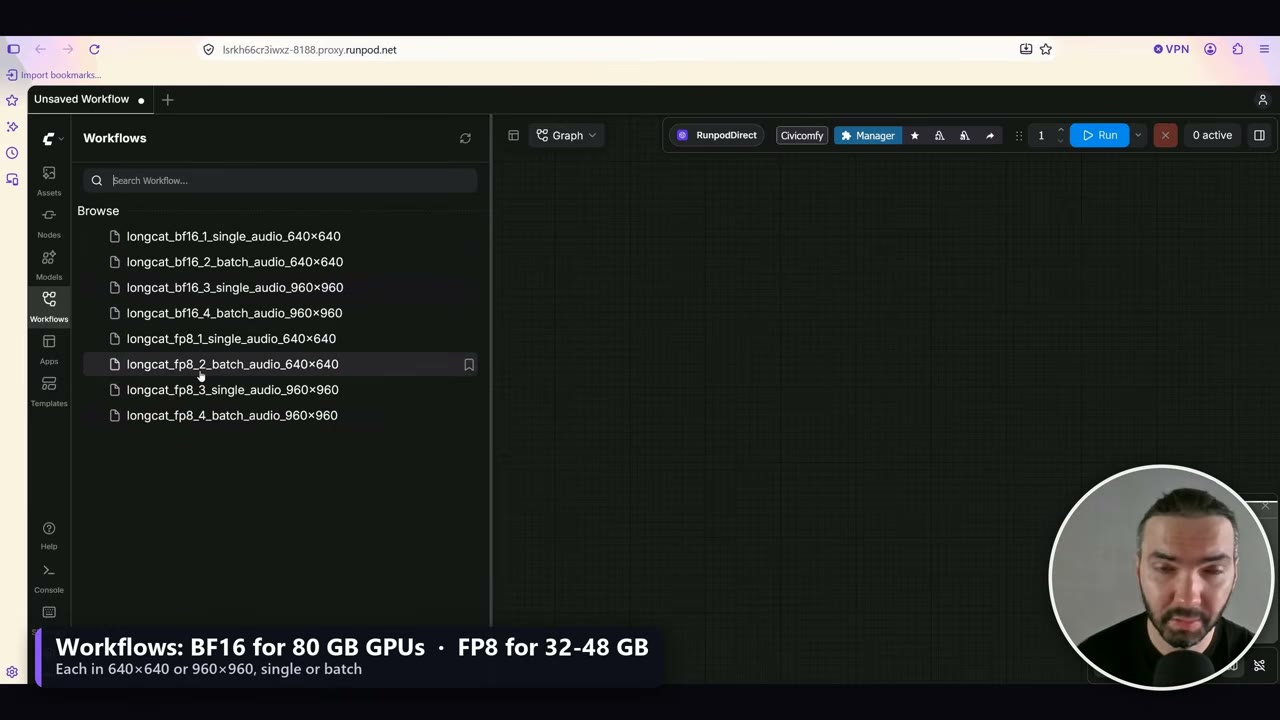
- Single audio rendert ein Voiceover. Er öffnet sich mit einem Beispielporträt und einem Beispiel-Voiceover von etwa einer Minute, sodass du ihn sofort testen kannst.
- Batch audio rendert jedes Voiceover in
ComfyUI/input/batch_audio/, je ein Video, eines nach dem anderen, mit demselben Porträt.
Lade deine eigenen Porträts und Voiceovers mit JupyterLab hoch: Porträts nach ComfyUI/input/, Batch-Voiceovers nach ComfyUI/input/batch_audio/.
Der Prompt ist optional. Für einen normalen Talking Avatar lass ihn leer. Du kannst etwas Bestimmtes verlangen, etwa „natural hand movement“.
Behalte die Hände im Porträt
LongCat kann die Hände schön bewegen. Aber wenn die Hände nicht in deinem Porträt sind, muss das Modell sie erfinden, sobald sie ins Bild kommen, und es erfindet nicht immer dieselben.
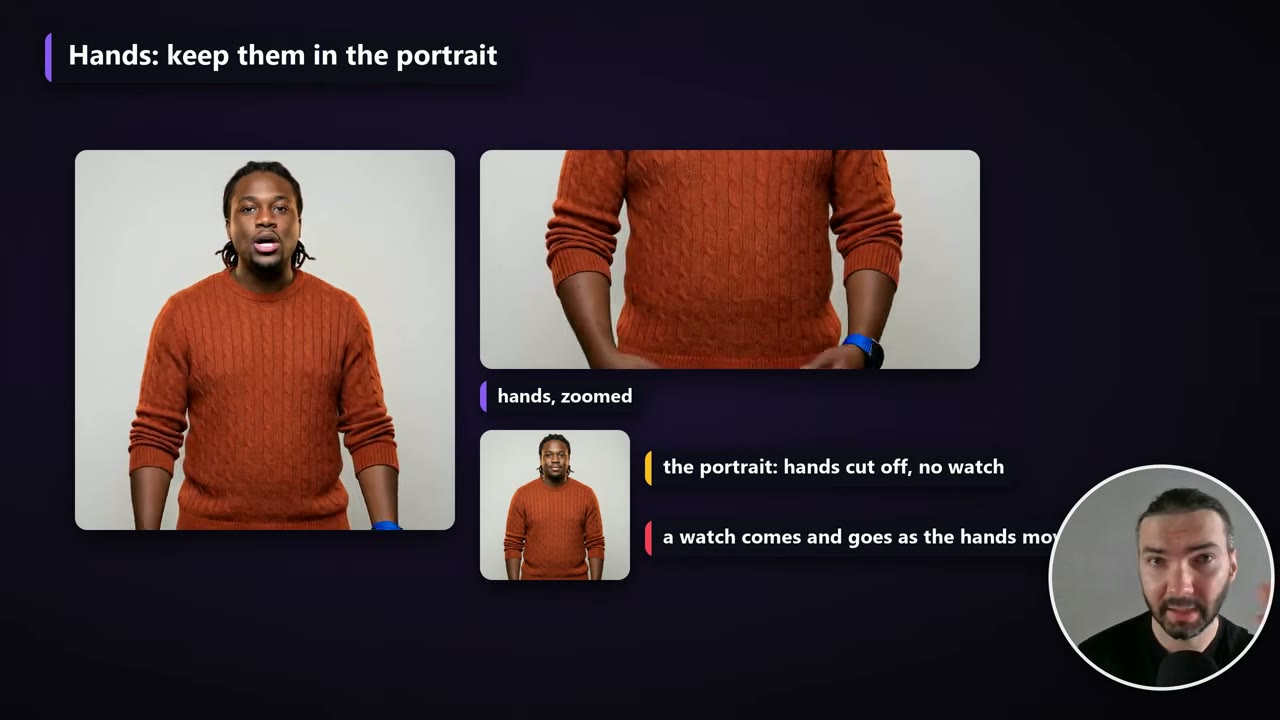
Wenn du Handbewegungen willst, nutze ein Porträt mit Händen, damit das Modell weiß, dass die Originalhände keine Uhr trugen. Eine Garantie ist das trotzdem nicht, aber es senkt das Risiko.
Wie LongCat Drift bei langen Videos vermeidet
Jedes Avatar-Modell rendert in Abschnitten: Keines rendert eine ganze Minute in einem Durchgang. Die Fenster von LongCat sind 3,7 Sekunden lang, und genau hier unterscheidet es sich von den anderen.
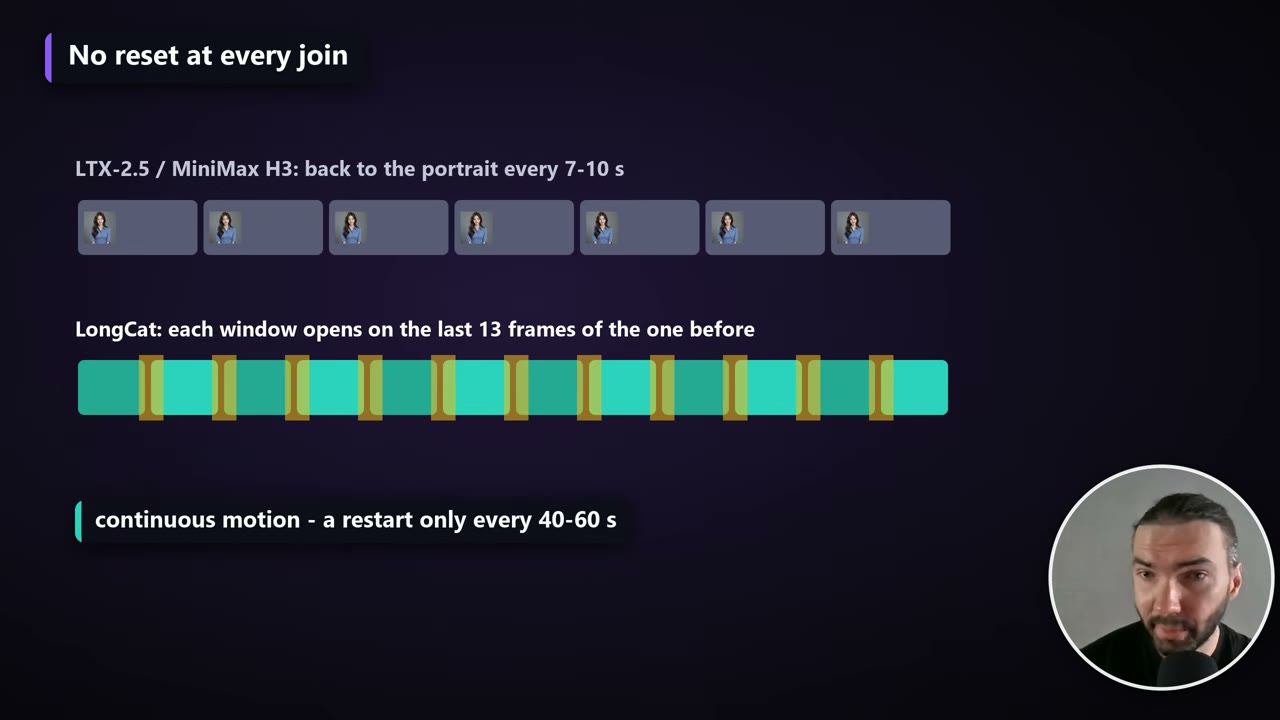
Bei meinen Templates für LTX-2.5 und MiniMax H3 kehrt jeder Abschnitt zum Originalporträt zurück. LongCat öffnet jedes Fenster mit den letzten 13 Frames des vorherigen, sodass die Bewegung durchgehend ist und du die Übergänge nicht siehst. Auch die Lippensynchronität hält über sie hinweg.
Das Fortsetzen hat allerdings sein eigenes Problem. Es bleibt etwa 40–70 Sekunden stabil; danach beginnt sich das Gesicht zu verändern, und Rauschen baut sich auf, das über ein Video von 10 oder 20 Minuten immer schlimmer wird.
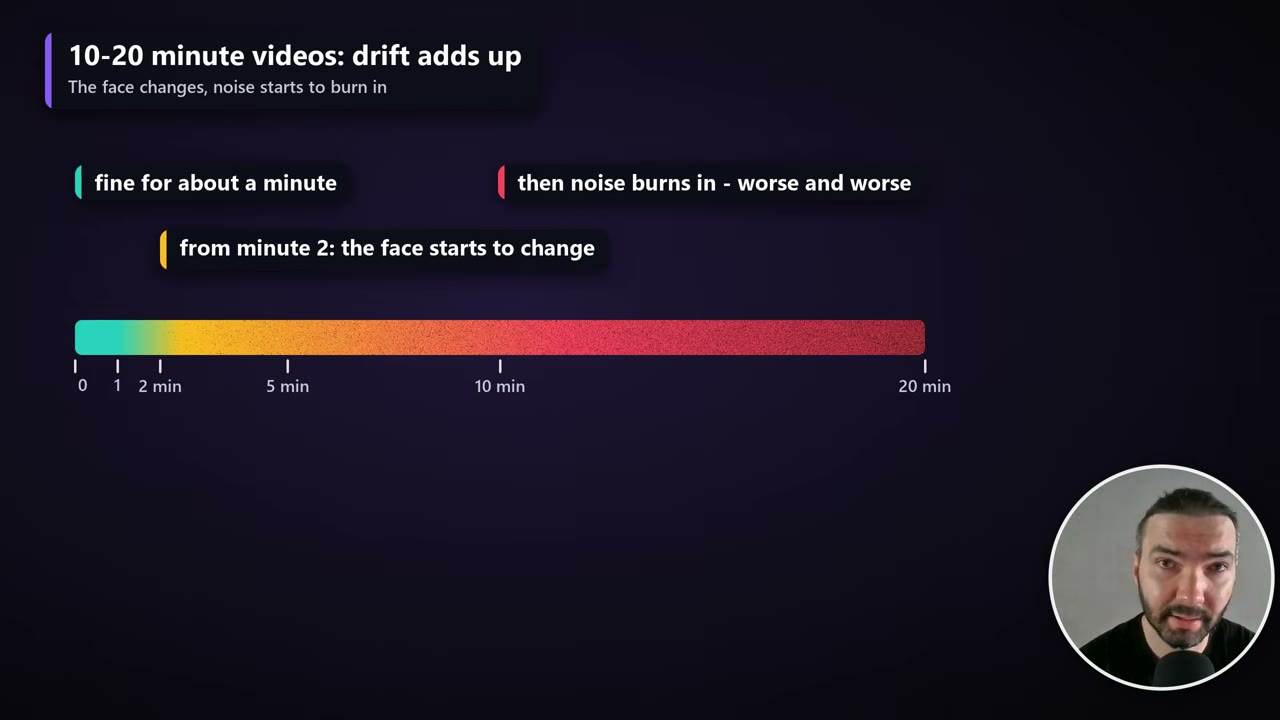
Deshalb erzwingen die Workflows alle 40–60 Sekunden einen Neustart vom Originalporträt. Die Neustarts werden vor Beginn des Renderns anhand des ganzen Voiceovers geplant, und jeder liegt mitten in einer echten Pause (mindestens 0,4 Sekunden nahezu Stille), sodass der Mund auf beiden Seiten des Schnitts geschlossen ist. Es sieht ein wenig aus wie ein schneller Schnitt zurück zum Porträt.
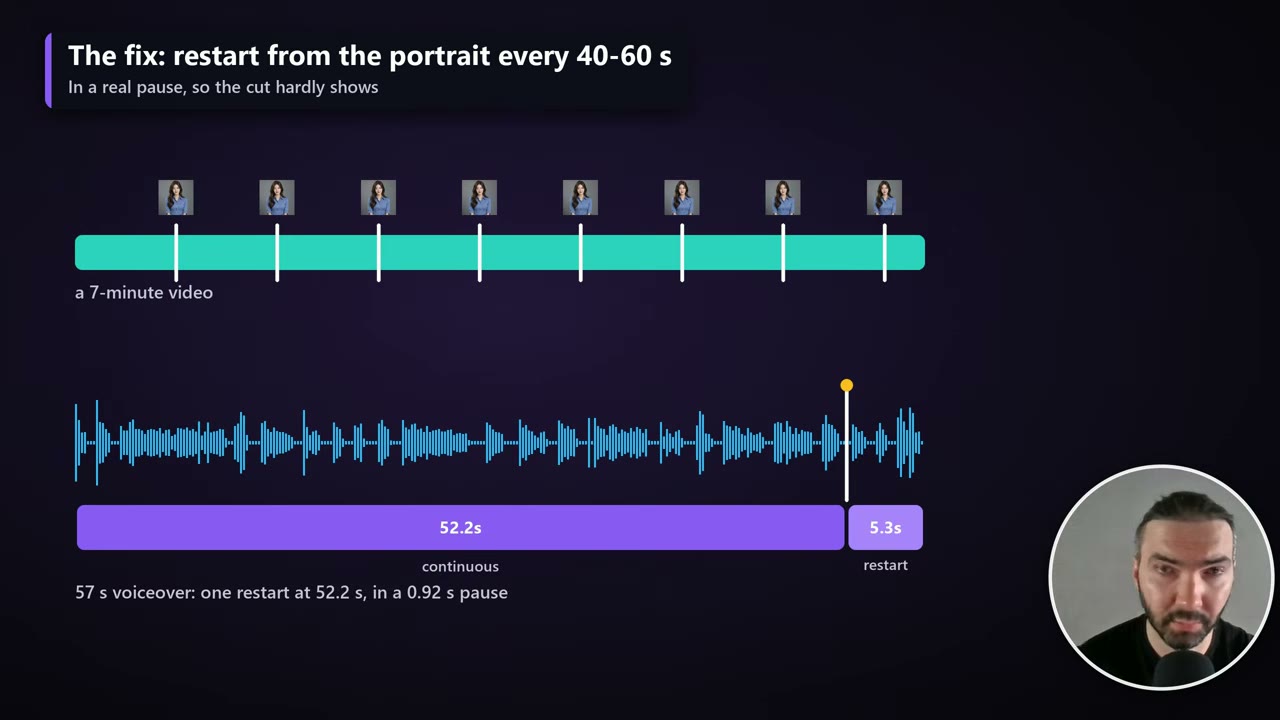
Der Plan wird im Log ausgegeben und als output/longcat_longform/<name>/restart_plan.txt gespeichert.
Rendern
Reihe den Workflow ein und beobachte die Konsole. Das Laden des Modells dauert jedes Mal ein paar Minuten, deshalb ist der erste Abschnitt der langsame. Danach sind es ein paar Minuten pro 3-Sekunden-Abschnitt, und so kommt es, dass eine Minute Video etwa eine Stunde dauert.
Jeder Eintrag in der Warteschlange rendert den nächsten unfertigen Abschnitt. Die README des Templates empfiehlt, die Batch-Anzahl auf mindestens die Länge des Voiceovers in Sekunden ÷ 3,2 plus einen Puffer zu setzen; überzählige Einträge werden in Millisekunden übersprungen.
- Abschnitte werden in
output/longcat_longform/<voiceover name>/gespeichert. - Wenn der Auftrag unterbrochen wird, reihe ihn erneut ein, und er macht beim letzten fertigen Abschnitt weiter.
- Wenn er fertig ist, wird das komplette Video in
ComfyUI/output/zusammengesetzt. Rechtsklick in JupyterLab zum Herunterladen.
Die eine Einstellung, die sich zu ändern lohnt
Die Workflows haben jede Menge Notizen, und sie funktionieren so, wie sie sind; ich rate davon ab, viel zu ändern. Die Ausnahme ist der Abstand der Neustarts: restart_min_seconds und restart_max_seconds am Node Split (standardmäßig 40 und 60).
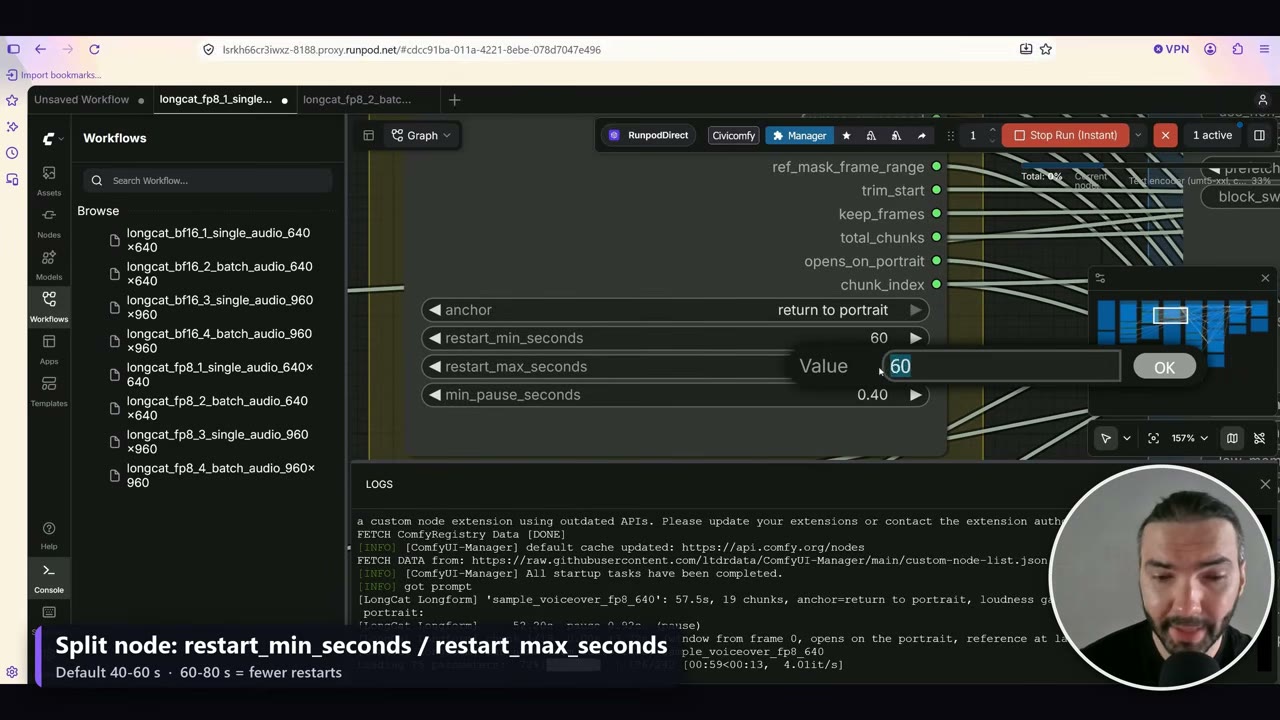
Mit 60–80 Sekunden sucht der Workflow stattdessen eine Pause in diesem Bereich, sodass es weniger Schnitte zurück zum Porträt gibt.
Wenn du fertig bist
Stoppe den Pod, wenn der Render abgeschlossen ist. Deine Modelle, Inputs und Outputs bleiben auf dem Volume. Wenn das Projekt vorbei ist, lösche auch das Volume, sonst wird es weiter berechnet.
Fehler, die du vermeiden solltest
- Eine GPU nur nach VRAM auswählen. Die normale RTX PRO 4500 hat 32 GB VRAM, aber nur 30 GB RAM; nimm die SE-Version oder eine 5090.
- BF16 auf einer 32-GB-Karte nutzen. BF16 ist für 80-GB-GPUs; nutze auf kleineren Karten die FP8-Workflows.
- Ein Porträt ohne Hände, wenn du Handbewegungen willst.
- Direkt einen langen Auftrag starten. Prüfe den ersten Abschnitt auf Lippensynchronität, Gesicht und Hintergrund.
- Das Volume vergessen. Ein gestoppter Pod kostet wenig; Speicher wird jeden Monat berechnet.
Wenn du dich über meinen RunPod-Empfehlungslink registrierst, bekommst du 5–500 $ RunPod-Guthaben. Ohne Empfehlungslink gibt es keinen Bonus. Ich bekomme denselben Bonus und nutze ihn für Rechenzeit.
Die Videoversion ansehen (10:27)
Alles oben steht auch im Video, falls du lieber am Bildschirm mitmachst. Das Video ist auf Englisch.
Häufige Fragen
Wie viel kostet eine Minute LongCat-Talking-Avatar-Video?
In meinen Läufen (Preise vom Oktober 2026): etwa 4,02 $ auf einer H100 SXM bei 960 × 960 mit dem BF16-Modell, etwa 1,97 $ auf einer RTX PRO 4500 bei 960 × 960 mit FP8 und etwa 1,03 $ auf einer RTX PRO 4500 bei 640 × 640 mit FP8.
Wie lange braucht LongCat, um eine Minute Video zu rendern?
Etwa eine Stunde auf einer H100, etwa 2,7 Stunden auf einer RTX PRO 4500 bei 960 × 960 und etwa 1,4 Stunden auf einer RTX PRO 4500 bei 640 × 640.
Wie viel VRAM und RAM braucht LongCat?
Mindestens 32 GB VRAM mit dem FP8-Modell, dazu 60 GB oder mehr System-RAM. Mit nur 30 GB RAM wird das Modell für jeden Abschnitt neu geladen, was viel langsamer ist und den Render komplett zum Stocken bringen kann.
Warum springt das Video etwa jede Minute zurück zum Porträt?
LongCat setzt jeden Abschnitt am vorherigen fort, was nahtlos aussieht, aber über lange Videos driftet. Die Workflows starten alle 40–60 Sekunden neu vom Porträt, mitten in einer echten Pause, damit das Gesicht treu bleibt.
Kann ich LongCat lokal statt auf RunPod ausführen?
Ja, wenn du die GPU und den RAM hast. Alles liegt auf GitHub; bitte Claude oder eine andere KI, die Dateien zu holen und in der Reihenfolge von setup.sh zu installieren.
Anton Tenitsky ist 3D-Artist mit mehr als 15 Jahren Erfahrung in der Computergrafik, tätig für Nickelodeon, Gameloft, Marvel Rivals und viele weitere Kunden. Mehr über mich