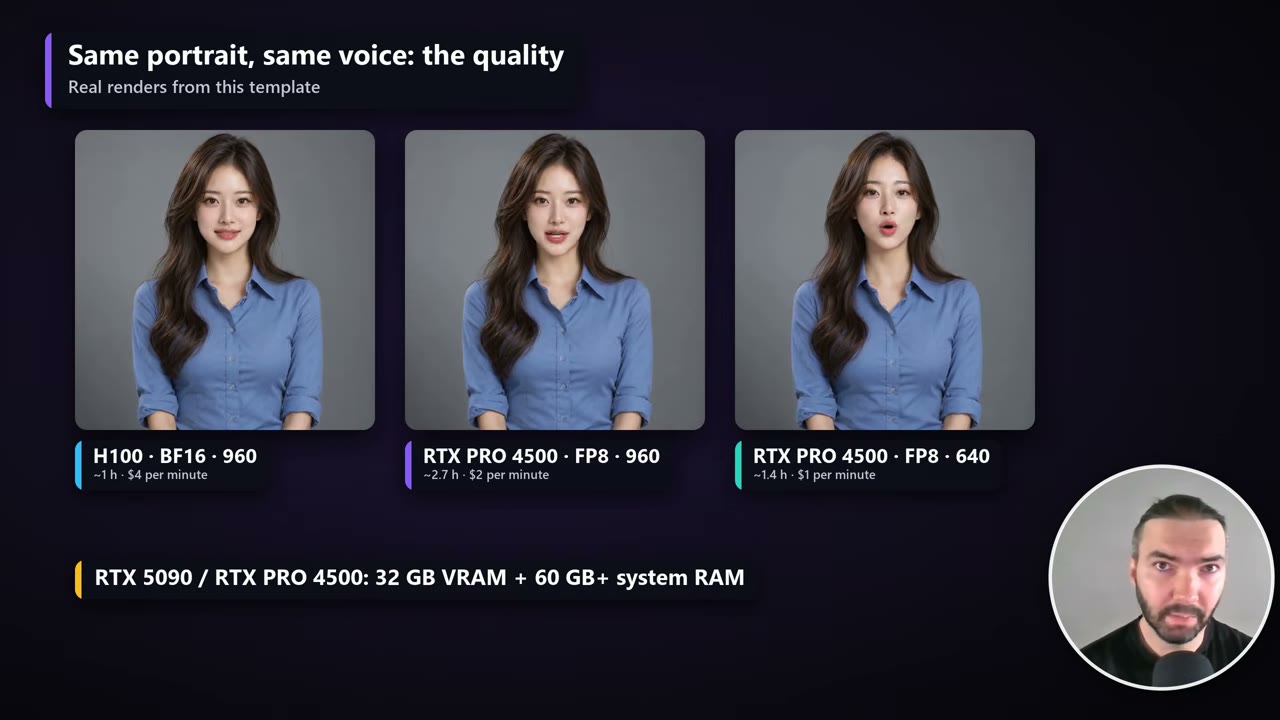
ステータス: RunPodで検証済み. このテンプレートで、RunPodのH100 SXMとRTX PRO 4500を使ってレンダリングしました。このガイドの時間と費用は、それらの実行に基づいています。
これまでにレンダリングした中で、最も高品質なトーキングアバターです。LongCat-Video-Avatar 1.5はMeituanのオープンウェイトモデルで、一般的な動画ではなく、話している人物に特化して学習されています。ポートレート1枚と任意の長さのナレーションを渡すと、元の音声付きでリップシンクした動画を返します。手の動きのある上半身の構図にも対応します。
品質には代償があります。重いモデルで、レンダリングは遅いです。このガイドでは、私が作ったテンプレート、RunPodでのセットアップ方法、選ぶべきGPU(システムRAMはVRAMと同じくらい重要です)、そして完成1分あたりの実際の費用を説明します。
ポイント
- 完成1分あたりの費用: H100で約4ドル、RTX PRO 4500の960 × 960で2ドル、640 × 640で1ドル(2026年10月の料金)。
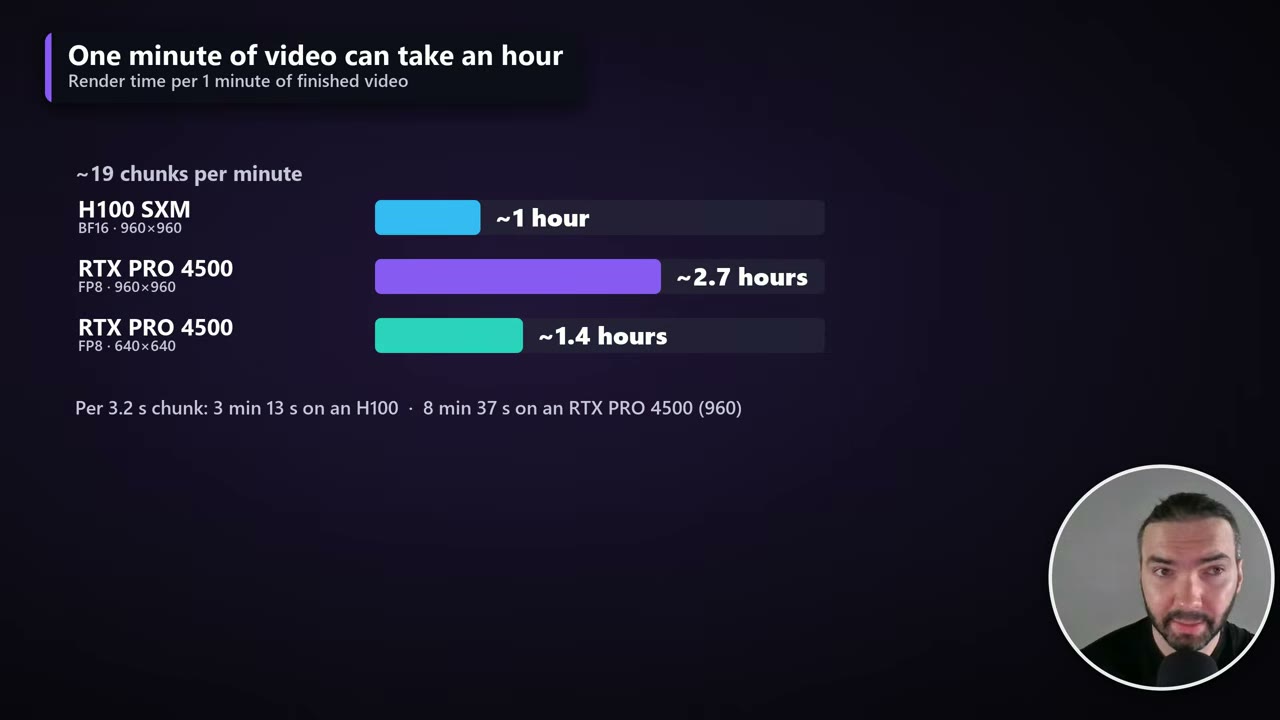
- 完成1分あたりのレンダリング時間: H100で約1時間、RTX PRO 4500で1.4〜2.7時間。
- ハードウェア: VRAM最低32GB、かつシステムRAM 60GB以上。
- 仕組み: 3.7秒のウィンドウがそれぞれ前のウィンドウから続くので、つなぎ目ごとのリセットがありません。40〜60秒ごとに間の部分でポートレートから再スタートし、顔のずれを防ぎます。
- GitHubに無料テンプレートがあり、RunPodならワンクリックです。
費用
2026年10月にRunPodで計測した、完成動画1分あたりの数字です。
| GPU | モデル、キャンバス | 料金 | 1分あたりのレンダリング時間 | 1分あたりの費用 |
|---|---|---|---|---|
| H100 SXM | BF16、960 × 960 | $4.00/時 | 約1時間 | 約$4.02 |
| RTX PRO 4500 | FP8、960 × 960 | $0.72/時 | 約2.7時間 | 約$1.97 |
| RTX PRO 4500 | FP8、640 × 640 | $0.72/時 | 約1.4時間 | 約$1.03 |
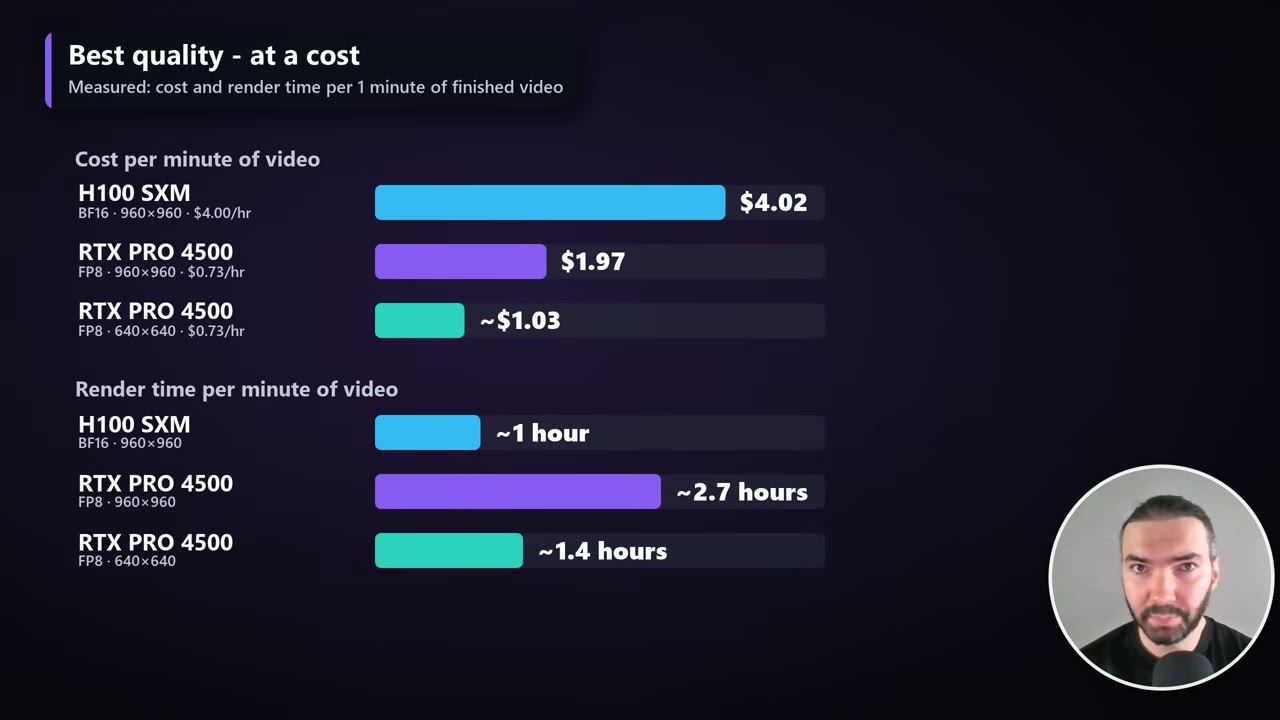
動画1分は約19チャンクです。3.2秒のチャンク1つに、H100で約3分13秒、RTX PRO 4500の960 × 960で約8分37秒かかりました。
品質:BF16とFP8、960と640
テンプレートには2種類のモデルが入っています。BF16はH100などの80GB GPU向けのフル精度モデルです。FP8はRTX 5090やRTX PRO 4500などの32〜48GBカード向けの小さなコピーです。並べて比べるとこうなります。
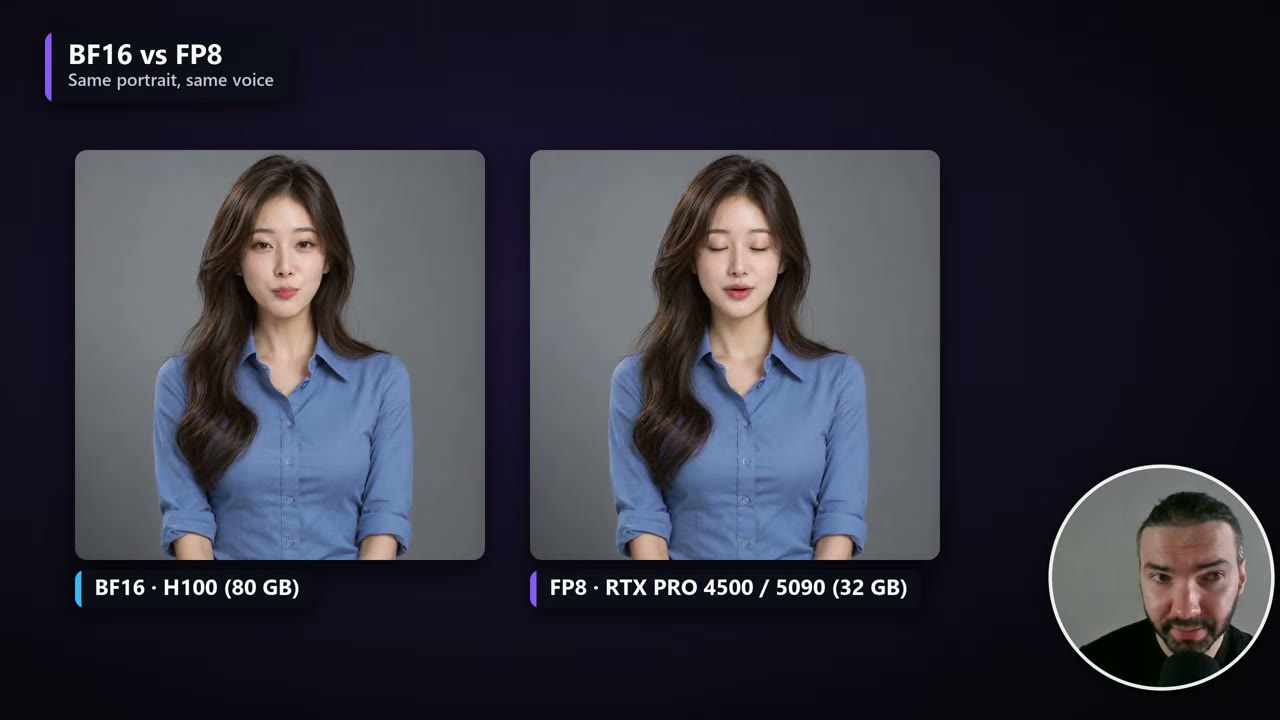
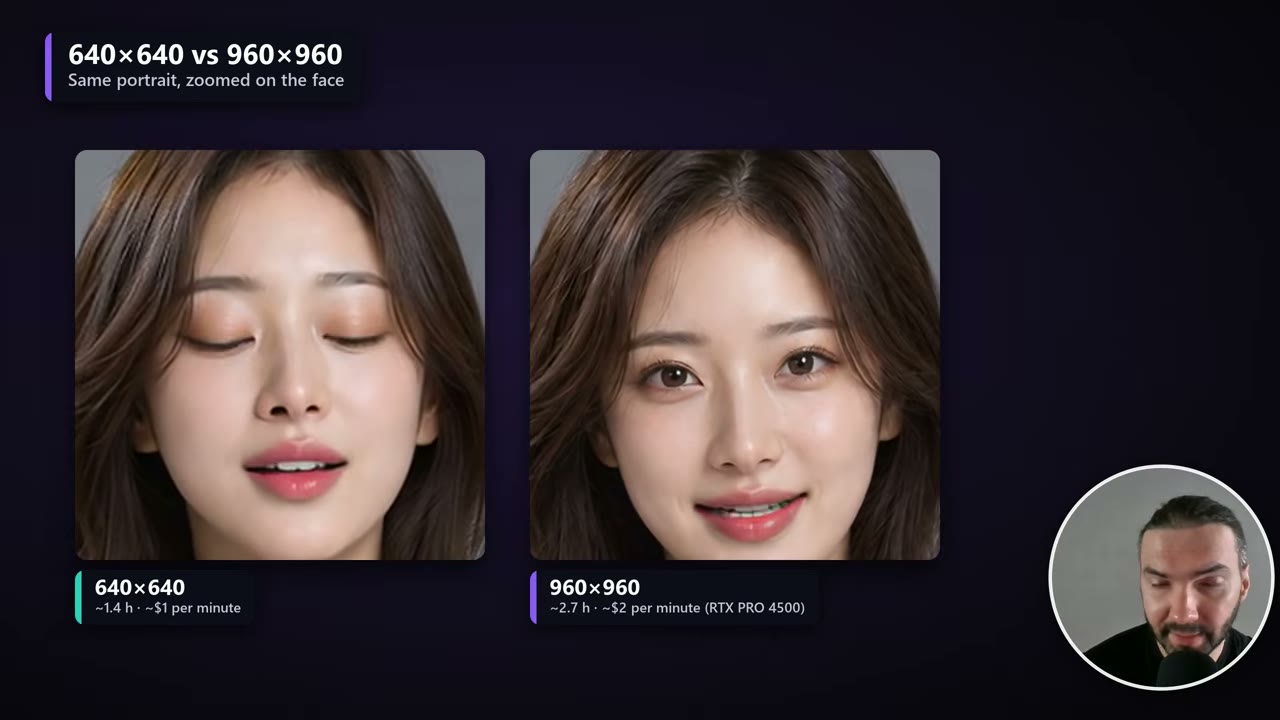
差が大きいのはキャンバスサイズです。960 × 960は640 × 640より目に見えて良く、その分ずっと遅くなります。追加の費用に見合うかどうかはあなた次第です。
2つの動かし方
ワークフロー、カスタムノード、セットアップスクリプトは、すべてGitHubで無料です。
- RunPodで: ワンクリックのテンプレートがすべてセットアップします。このガイドの残りはこちらを扱います。
- ローカルのComfyUIで: ハードウェアがあれば、Claude(または任意のAI)にGitHubからファイルを取得させ、
setup.shの順番でインストールしてもらいます。ComfyUIにはネイティブのLongCatノードがなく、モデルはkijaiのComfyUI-WanVideoWrapperを通して動きます。スクリプトはこれを固定したコミットでインストールします。
RunPodが初めてなら、RunPod入門でアカウント、ストレージ、Podを説明しています。
ストレージ:グローバルボリュームかネットワークボリュームか
RunPodには現在2種類の永続ストレージがあり、テンプレートはどちらでも動きます。今回はグローバルボリュームに切り替えました。
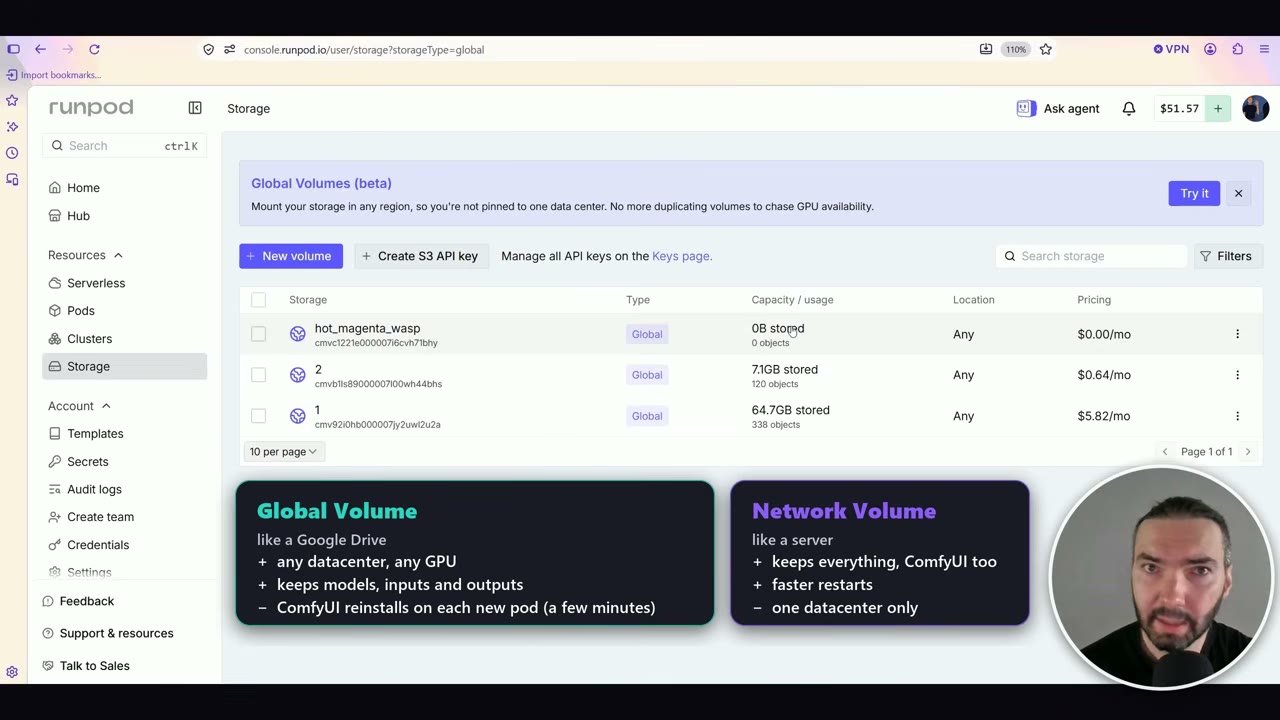
| グローバルボリューム | ネットワークボリューム | |
|---|---|---|
| 保持するもの | モデル、入力、出力 | ComfyUIのインストールを含むすべて |
| 使える場所 | どのデータセンターでも使えるので、選べるGPUがはるかに多い | 1つのデータセンターのみ |
| 再起動時間 | 数分余計にかかる:新しいPodごとにComfyUIを再インストール | より速い |
| 料金(2026年10月) | 1GBあたり月$0.09、保存した分だけ | 1GBあたり月$0.07、空でも予約したサイズ分 |
私にとって決め手は空き状況です。ネットワークボリュームでは1つのデータセンターに縛られ、そのデータセンターに空いているGPUがないことがよくあります。グローバルボリュームはどこのGPUにも接続できます。
私の場合は安くもなります。実際に保存した分だけを時間単位で支払うからです。私のLongCatのボリュームは64.7GBで、月5.82ドルになります。いつでも削除でき、削除すれば課金は止まります。
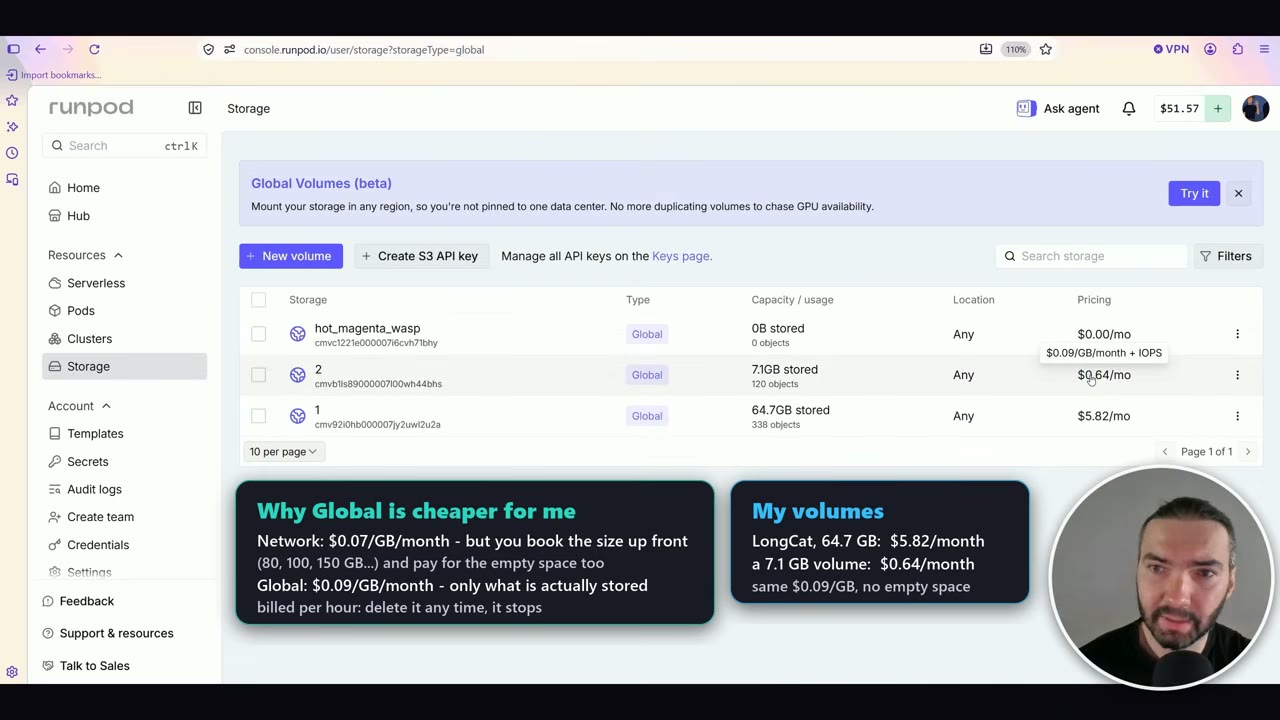
グローバルボリュームはまだベータ版です。RunPodのドキュメントで知っておくべき点が1つあります。アカウント残高が0ドルになると、グローバルボリュームにフラグが付き、15日後に完全に削除されます。
セットアップ方法:テンプレートのリンクを開き、Storage → New volumeでGlobal volumeを選んで作成し、それを選んでConfigure Pod with volumeをクリックします。デプロイページにはまだどこにも「Global」と表示されませんが、ボリュームは接続されています。
どのGPUか:VRAMとシステムRAM
LongCatには、FP8モデルで最低32GBのVRAMと、60GBを超えるシステムRAMが必要です。落とし穴はRAMです。
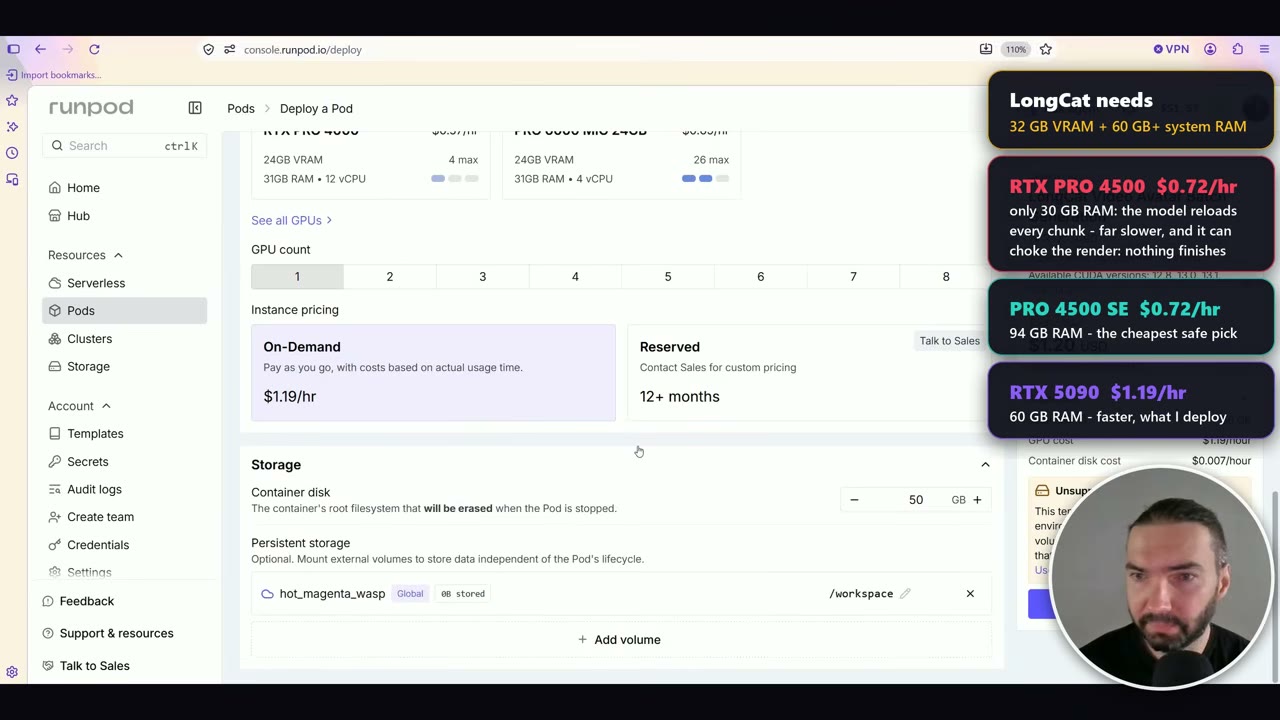
| GPU | VRAM | システムRAM | 料金(2026年10月) | 備考 |
|---|---|---|---|---|
| RTX PRO 4500 | 32GB | 30GB | $0.72/時 | 避ける:チャンクごとにモデルが再読み込みされる |
| RTX PRO 4500 SE | 32GB | 94GB | $0.72/時 | 最も安い安全な選択 |
| RTX 5090 | 32GB | 60GB | $1.19/時 | より速い |
| H100 SXM | 80GB | – | $4.00/時 | フルのBF16モデルが動く |
RAMが30GBしかないと、チャンクごとにモデルを再読み込みしなければなりません。そのためレンダリングがはるかに遅くなり、完全に止まることもあります。
デプロイと初回起動
- Podをデプロイします。 デプロイページに**「Unsupported volume type」**という警告が出ることがあります。このテンプレートでは無視して構いません。
- リソースがないと表示されたら、もう一度Deployをクリックします。 RunPodは2回目で通ることがあります。
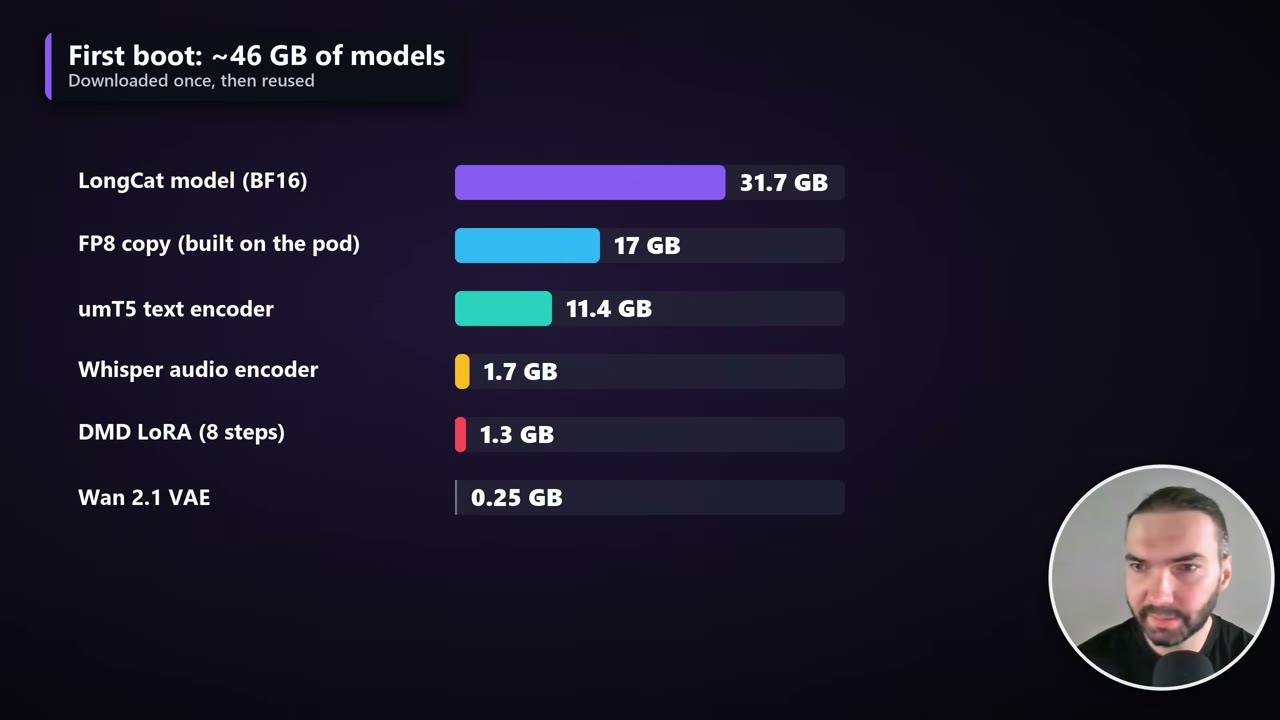
- ダウンロードを待ちます。 初回起動では約46GBのモデルを1回だけダウンロードします。PodはBF16ファイルからFP8のコピーも作るので、モデルは合計で約63GBになります。2回目以降の起動ではそれを再利用します。
- すべてダウンロードされたのにComfyUIが起動しない場合は、Podを停止して再起動します。 収録中に私にも起きました。
- Podの接続メニューからComfyUIとJupyterLabを開きます。JupyterLabは実際には準備できているのに「initializing」と表示し続けることがあるので、開いてみてください。
ワークフロー
ComfyUIを開き、Workflowsサイドバーを開きます。ワークフローは8つあります。BF16かFP8、640 × 640か960 × 960、そしてそれぞれに単一ナレーション版とバッチ版があります。
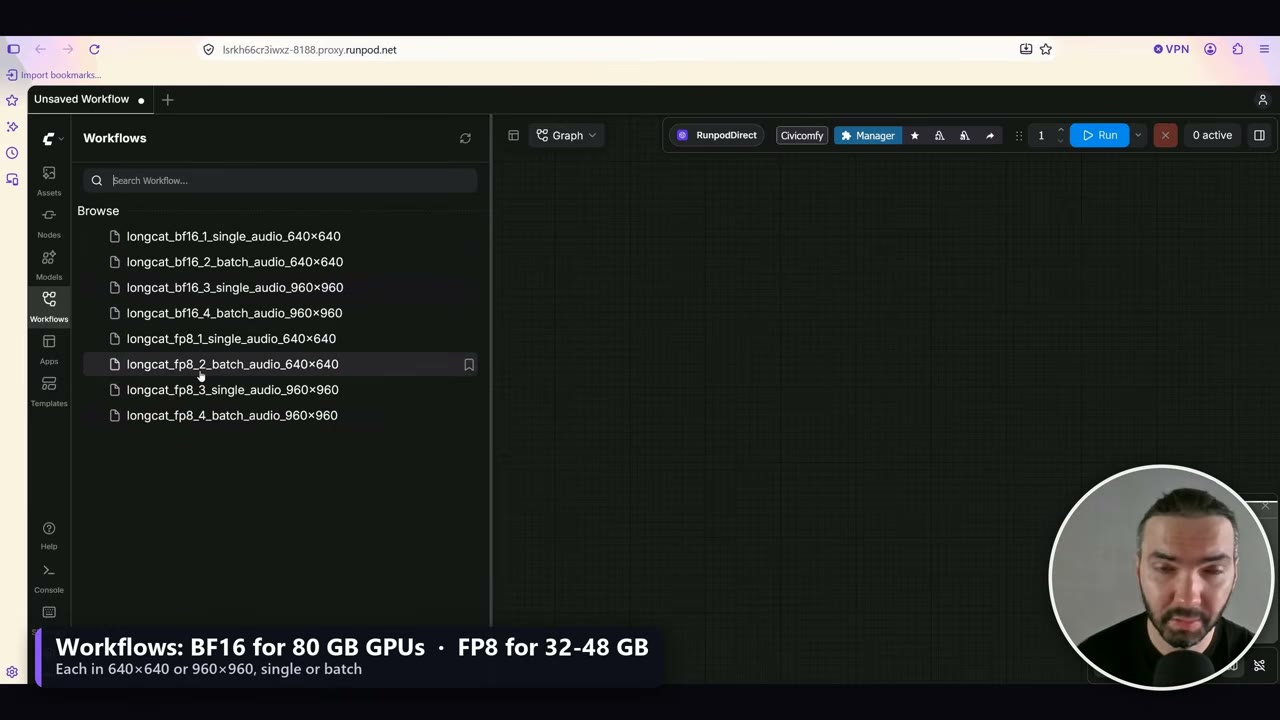
- Single audioは1つのナレーションをレンダリングします。サンプルのポートレートと約1分のサンプルナレーションが読み込まれた状態で開くので、すぐにテストできます。
- Batch audioは
ComfyUI/input/batch_audio/内のすべてのナレーションを、同じポートレートで1本ずつ順番に1つの動画にレンダリングします。
自分のポートレートとナレーションはJupyterLabでアップロードします。ポートレートはComfyUI/input/に、バッチ用のナレーションはComfyUI/input/batch_audio/に置きます。
プロンプトは任意です。 普通のトーキングアバターなら空欄のままにします。「natural hand movement」のように、具体的なことを頼むこともできます。
ポートレートに手を入れる
LongCatは手をきれいに動かせます。ただし、ポートレートに手が写っていないと、手がフレームに入ってきたときにモデルが手を作り出さなければならず、いつも同じ手を作るとは限りません。
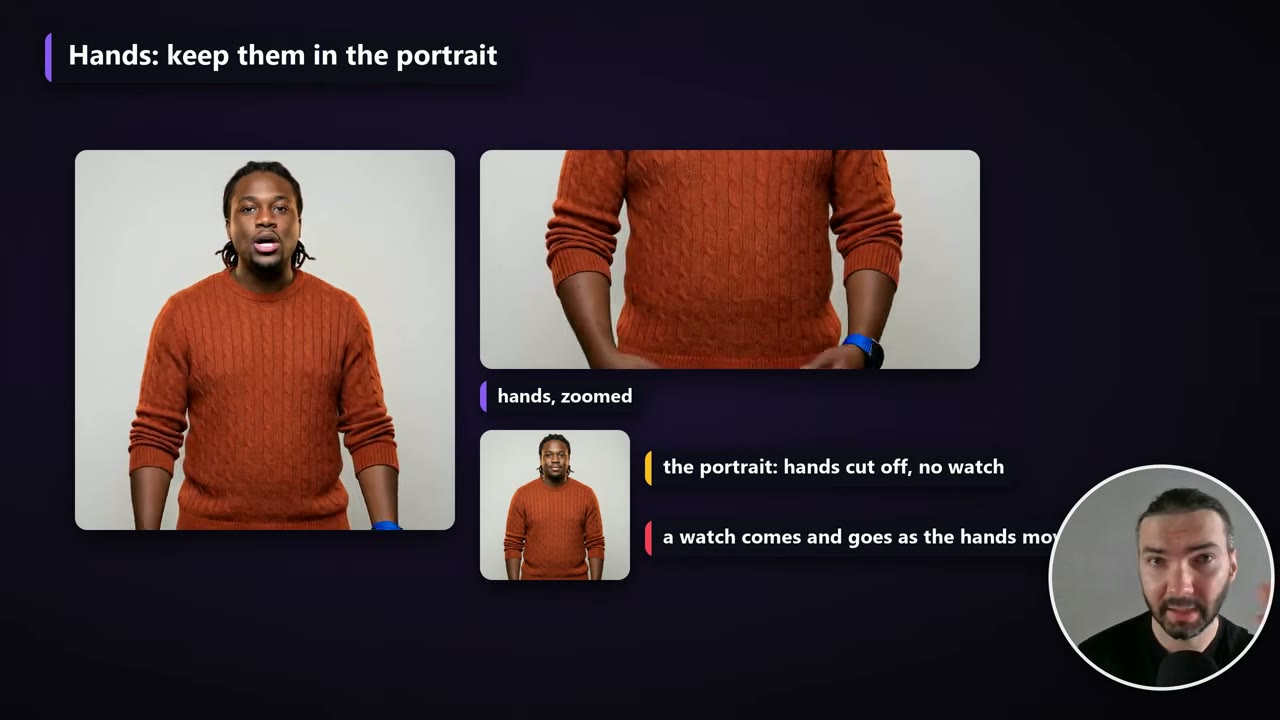
手の動きが欲しいなら、手が写ったポートレートを使ってください。そうすれば、元の手に腕時計がなかったことをモデルが分かります。それでも保証はありませんが、リスクは下がります。
LongCatが長い動画でずれを防ぐ方法
どのアバターモデルもチャンク単位でレンダリングします。1分全体を一度にレンダリングできるものはありません。LongCatのウィンドウは3.7秒で、ここが他のモデルとの違いです。
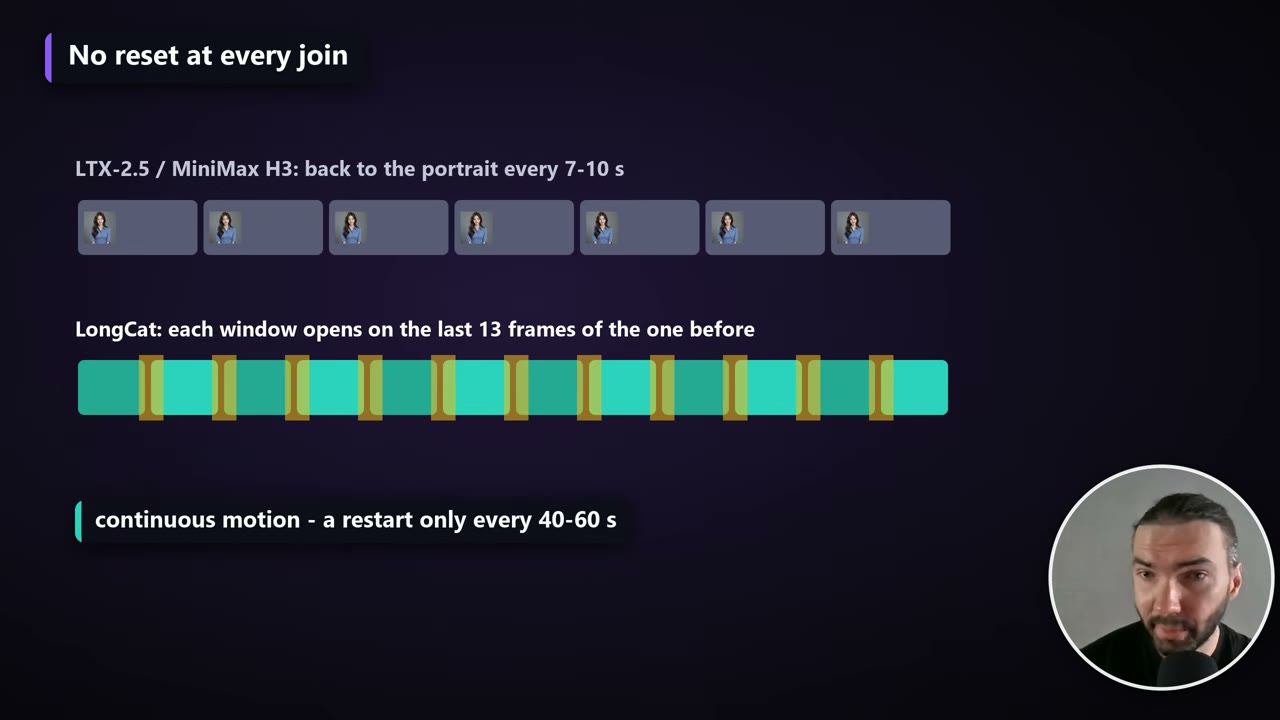
私のLTX-2.5とMiniMax H3のテンプレートでは、どのチャンクも元のポートレートに戻ります。LongCatは各ウィンドウを前のウィンドウの最後の13フレームで始めるので、動きが連続し、つなぎ目が見えません。リップシンクもつなぎ目をまたいで保たれます。
ただし、続けて生成することには別の問題があります。安定しているのは約40〜70秒で、その後は顔が変わり始めてノイズが蓄積し、10分や20分の動画ではどんどん悪くなります。
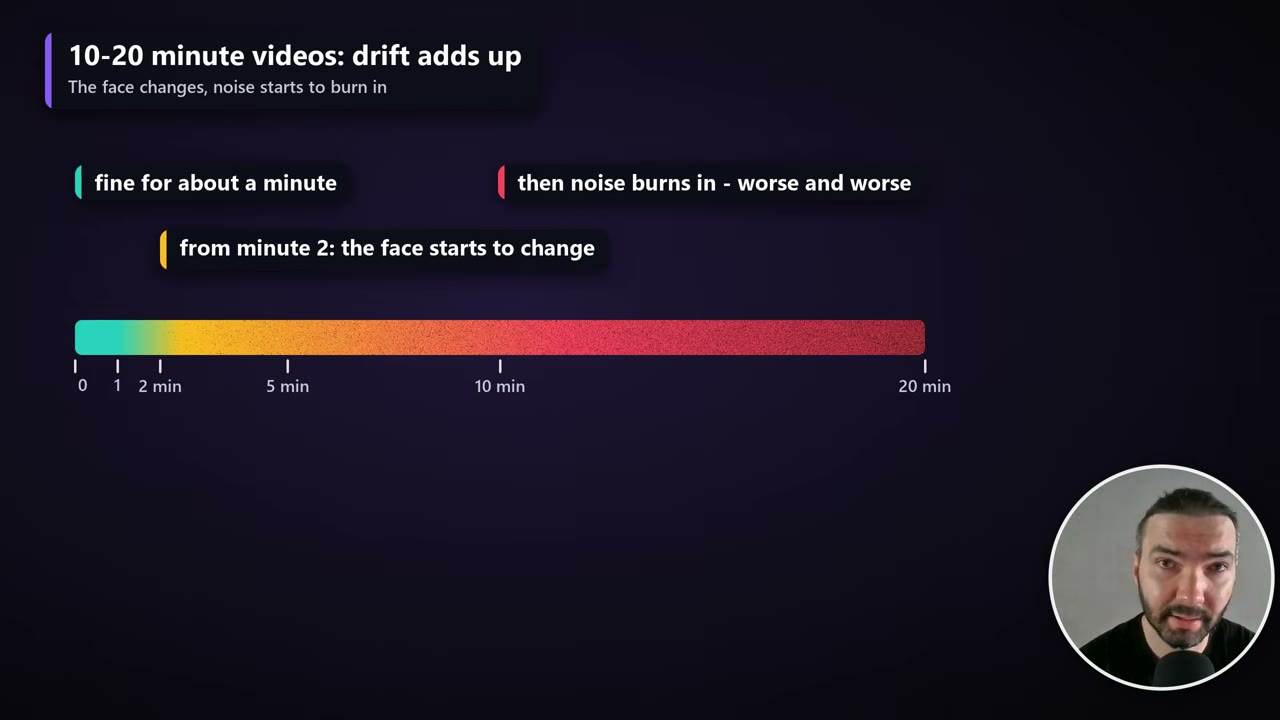
そこでワークフローは、40〜60秒ごとに元のポートレートから再スタートさせます。再スタートの位置はレンダリング開始前にナレーション全体から計画され、それぞれ実際の間(少なくとも0.4秒のほぼ無音)の途中に置かれるので、カットの前後で口は閉じています。ポートレートへ素早くカットバックしたように少し見えます。
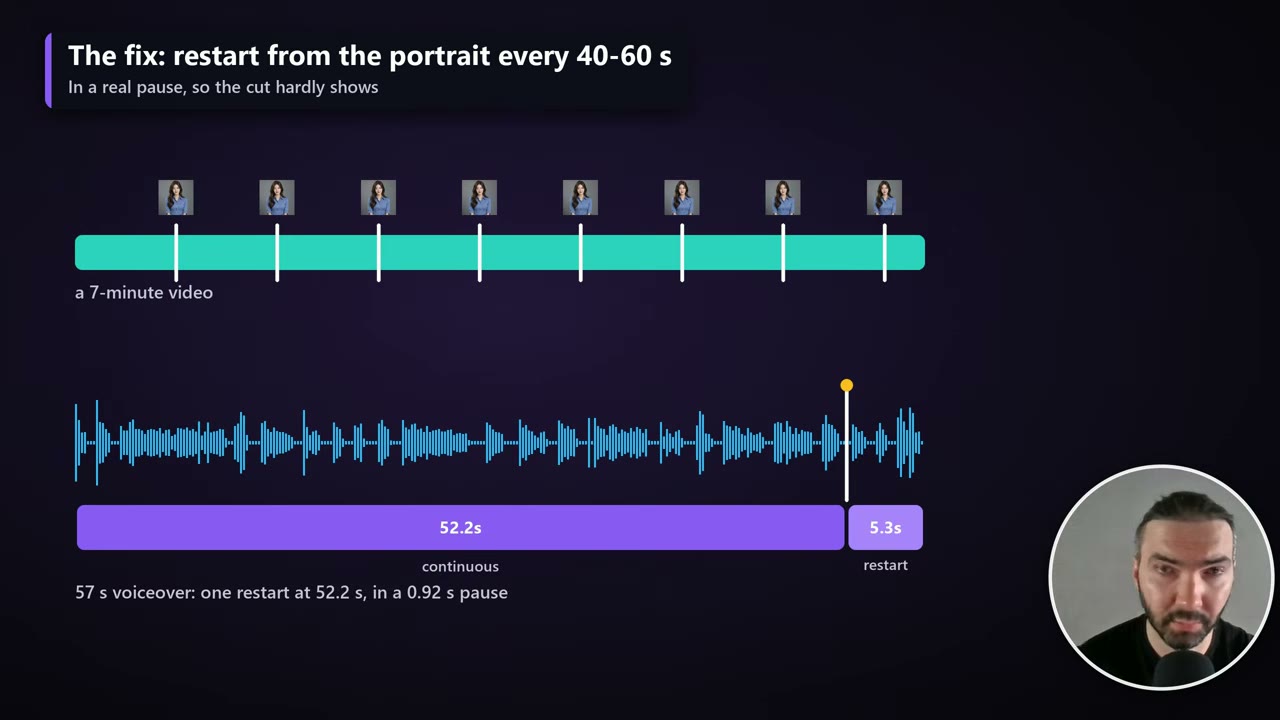
計画はログに出力され、output/longcat_longform/<name>/restart_plan.txtとして保存されます。
レンダリング
ワークフローをキューに入れ、コンソールを見守ります。モデルの読み込みに毎回数分かかるので、最初のチャンクが遅くなります。その後は3秒のチャンクごとに数分で、こうして動画1分に約1時間かかることになります。
キューの各項目が、次の未完了チャンクをレンダリングします。テンプレートのREADMEには、バッチ数を少なくともナレーションの秒数÷3.2に余裕を加えた数に設定するよう書かれています。余った項目は数ミリ秒でスキップされます。
- チャンクは
output/longcat_longform/<voiceover name>/に保存されます。 - 作業が中断されたら、 もう一度キューに入れれば、最後に完了したチャンクから再開します。
- 完了すると、 完成した動画が
ComfyUI/output/に組み立てられます。JupyterLabで右クリックしてダウンロードします。
変える価値のある設定は1つだけ
ワークフローには説明のメモがたくさんあり、そのままで動きます。あまり変えることはおすすめしません。例外は再スタートの間隔で、Splitノードのrestart_min_secondsとrestart_max_seconds(デフォルトは40と60)です。
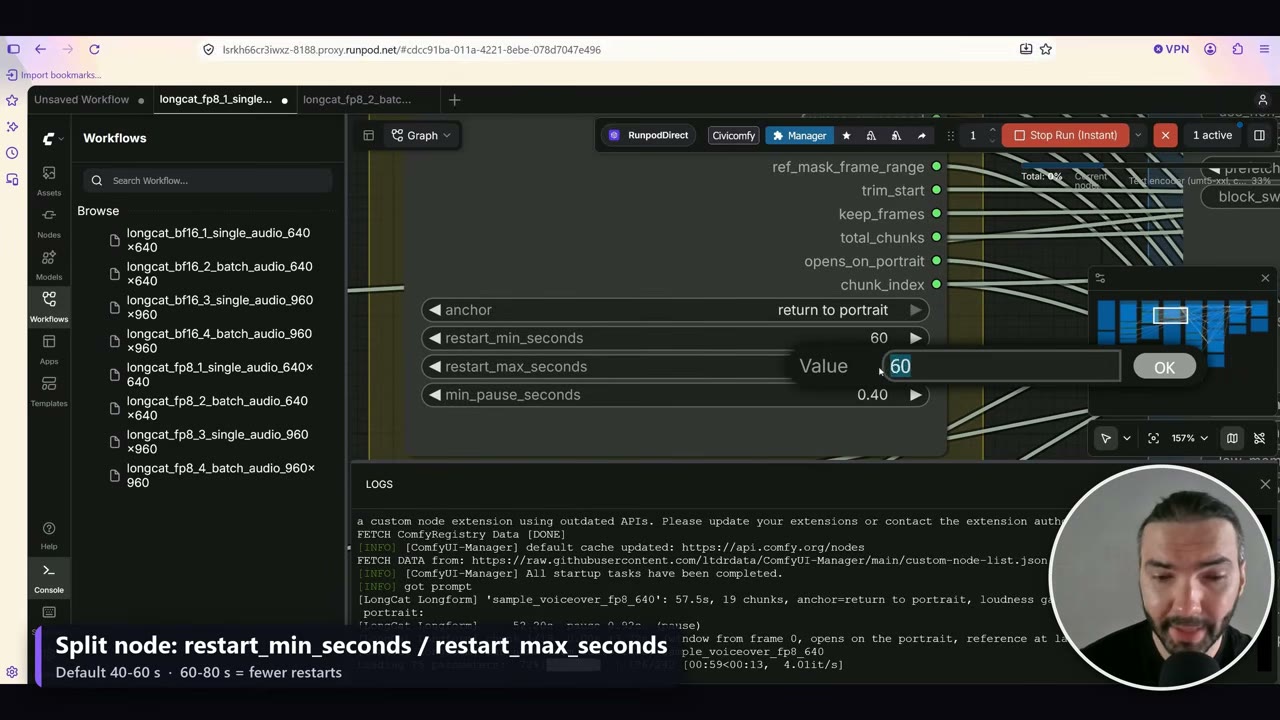
60〜80秒にすると、ワークフローはその範囲で間を探すので、ポートレートへのカットバックが減ります。
終わったら
レンダリングが終わったらPodを停止します。モデル、入力、出力はボリュームに残ります。プロジェクトが終わったら、ボリュームも削除してください。さもないと課金され続けます。
避けたい失敗
- VRAMだけでGPUを選ぶ。 無印のRTX PRO 4500はVRAMが32GBでもRAMは30GBしかありません。SE版か5090を選んでください。
- 32GBカードでBF16を使う。 BF16は80GB GPU向けです。小さいカードではFP8のワークフローを使ってください。
- 手の動きが欲しいのに手の写っていないポートレートを使う。
- いきなり長い作業に進む。 最初のチャンクでリップシンク、顔、背景を確認してください。
- ボリュームを忘れる。 停止したPodはほとんど費用がかかりませんが、ストレージは毎月課金されます。
私のRunPod紹介リンクから登録すると、5〜500ドルのRunPodクレジットがもらえます。紹介リンクを使わない場合、ボーナスはありません。私も同じボーナスを受け取り、計算リソースに使っています。
動画版を見る (10:27)
上の内容はすべて動画でも説明しています。画面を見ながら進めたい方はこちらをどうぞ。 動画は英語です。
よくある質問
LongCatのトーキングアバター動画は1分あたりいくらかかりますか?
私の実行(2026年10月の料金)では、H100 SXMで960 × 960のBF16モデルが約4.02ドル、RTX PRO 4500で960 × 960のFP8が約1.97ドル、RTX PRO 4500で640 × 640のFP8が約1.03ドルでした。
LongCatで動画1分をレンダリングするのにどのくらいかかりますか?
H100で約1時間、RTX PRO 4500の960 × 960で約2.7時間、RTX PRO 4500の640 × 640で約1.4時間です。
LongCatにはどのくらいのVRAMとRAMが必要ですか?
FP8モデルでVRAMが最低32GB、加えてシステムRAMが60GB以上必要です。RAMが30GBしかないと、チャンクごとにモデルが再読み込みされ、はるかに遅くなり、レンダリングが完全に止まることもあります。
なぜ動画が1分ほどごとにポートレートへ戻るのですか?
LongCatは各チャンクを前のチャンクから続けて生成します。継ぎ目なく見えますが、長い動画ではずれていきます。顔を保つため、ワークフローは40〜60秒ごとに、実際の間の途中でポートレートから再スタートします。
RunPodではなくローカルでLongCatを動かせますか?
GPUとRAMがあれば可能です。すべてGitHubにあるので、ClaudeなどのAIにファイルを取得させ、setup.shの順番でインストールしてもらってください。
Anton Tenitsky は コンピュータグラフィックスで15年以上の経験を持つ3Dアーティストで、Nickelodeon、Gameloft、Marvel Rivalsをはじめ多くのクライアントと仕事をしてきました。 プロフィールを見る