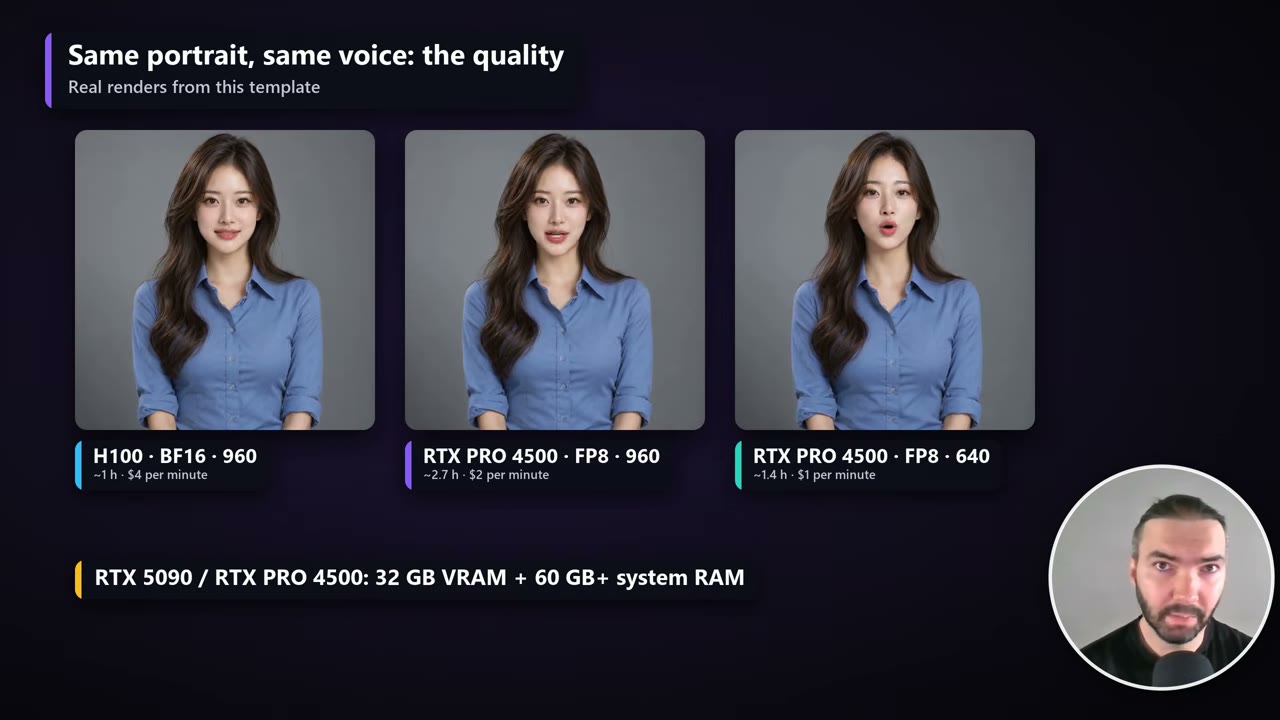
Estado: Probada en RunPod. Rendericé con esta plantilla en RunPod con una H100 SXM y una RTX PRO 4500. Los tiempos y costes de esta guía salen de esas ejecuciones.
Estos son los avatares parlantes de mayor calidad que he renderizado hasta ahora. LongCat-Video-Avatar 1.5 es un modelo de pesos abiertos de Meituan entrenado específicamente con personas hablando, no con vídeo general. Dale un retrato y una locución de cualquier duración, y te devuelve un vídeo con sincronización labial y tu audio original, incluido un encuadre de medio cuerpo con movimiento de manos.
La calidad tiene un precio: es un modelo pesado y renderiza despacio. Esta guía cubre la plantilla que he creado para él, cómo prepararla en RunPod, qué GPU elegir (la RAM del sistema importa tanto como la VRAM) y lo que cuesta de verdad un minuto terminado.
En resumen
- Coste por minuto terminado: unos 4 $ en una H100, 2 $ en una RTX PRO 4500 a 960 × 960 y 1 $ a 640 × 640 (precios de octubre de 2026).
- Tiempo de render por minuto terminado: alrededor de 1 hora en una H100, 1,4–2,7 horas en una RTX PRO 4500.
- Hardware: al menos 32 GB de VRAM y más de 60 GB de RAM del sistema.
- Cómo funciona: ventanas de 3,7 segundos, cada una continuando desde la anterior, así que no hay reinicio en cada unión. Un reinicio desde el retrato cada 40–60 segundos, en una pausa, evita que el rostro se desvíe.
- Plantilla gratuita en GitHub, o con un clic en RunPod.
Cuánto cuesta
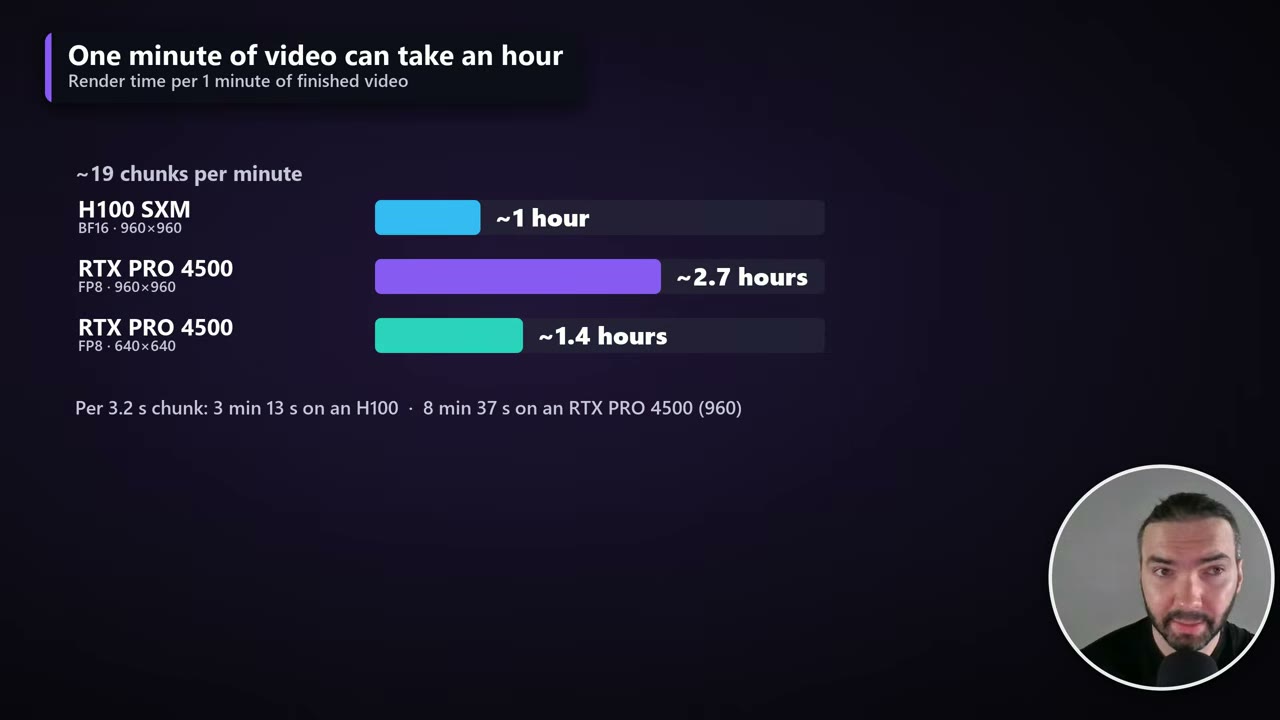
Estas son mis mediciones en RunPod en octubre de 2026, para un minuto de vídeo terminado:
| GPU | Modelo, lienzo | Precio | Tiempo de render por minuto | Coste por minuto |
|---|---|---|---|---|
| H100 SXM | BF16, 960 × 960 | $4.00/h | ~1 hora | ~4,02 $ |
| RTX PRO 4500 | FP8, 960 × 960 | $0.72/h | ~2,7 horas | ~1,97 $ |
| RTX PRO 4500 | FP8, 640 × 640 | $0.72/h | ~1,4 horas | ~1,03 $ |
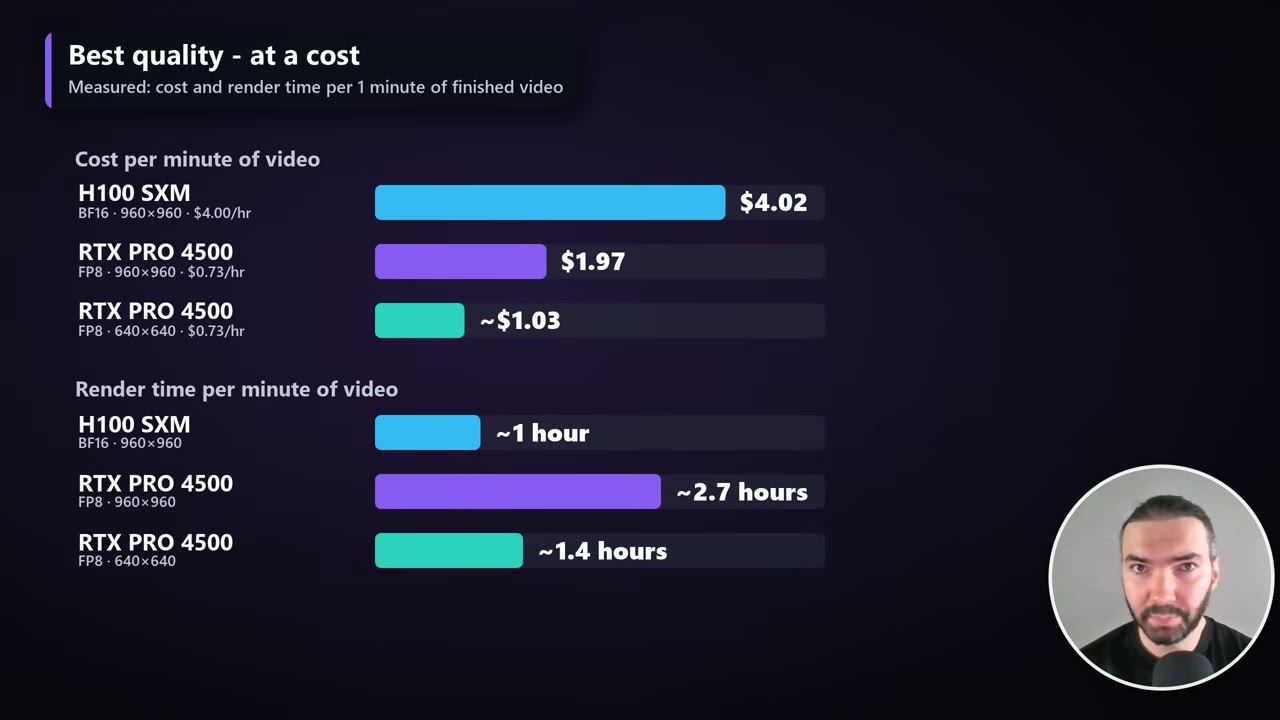
Un minuto de vídeo son unos 19 trozos. Un trozo de 3,2 segundos tardó unos 3 minutos y 13 segundos en la H100 y unos 8 minutos y 37 segundos en la RTX PRO 4500 a 960 × 960.
La calidad: BF16 frente a FP8, 960 frente a 640
La plantilla incluye dos versiones del modelo. BF16 es el modelo de precisión completa para GPU de 80 GB como la H100. FP8 es una copia más pequeña para tarjetas de 32–48 GB como la RTX 5090 o la RTX PRO 4500. Aquí están lado a lado:
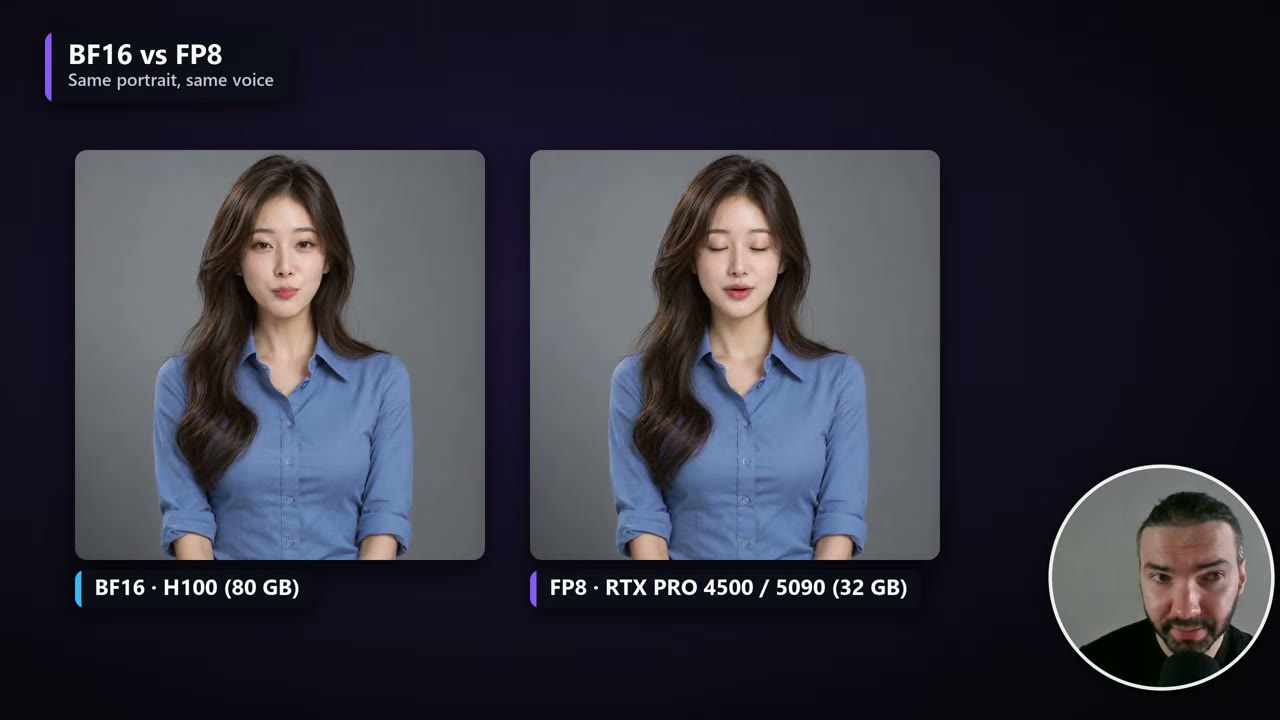
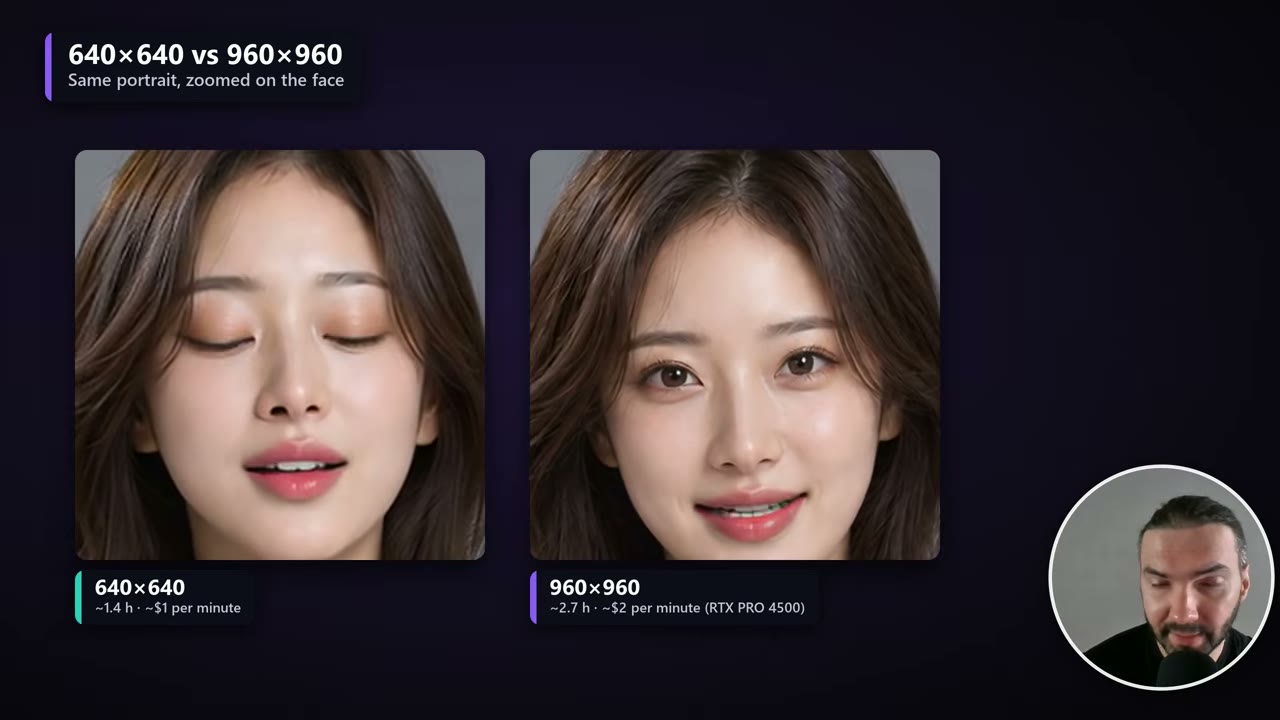
El tamaño del lienzo marca más diferencia. 960 × 960 se ve claramente mejor que 640 × 640, y es mucho más lento: si compensa el coste extra, lo decides tú.
Dos formas de ejecutarlo
Todo es gratuito en GitHub: los flujos, los nodos personalizados y el script de instalación.
- En RunPod: la plantilla de un clic lo prepara todo. Es lo que cubre el resto de la guía.
- En local en ComfyUI: si tienes el hardware, pídele a Claude (o a cualquier IA) que descargue los archivos de GitHub y los instale en el orden de
setup.sh. ComfyUI no tiene nodos nativos de LongCat; el modelo funciona a través de ComfyUI-WanVideoWrapper de kijai, que el script instala en un commit fijo.
Si nunca has usado RunPod, mi introducción a RunPod explica las cuentas, el almacenamiento y los pods.
Almacenamiento: volumen global o volumen de red
RunPod tiene ahora dos tipos de almacenamiento persistente, y la plantilla funciona con ambos. Para esta me pasé a un volumen global.
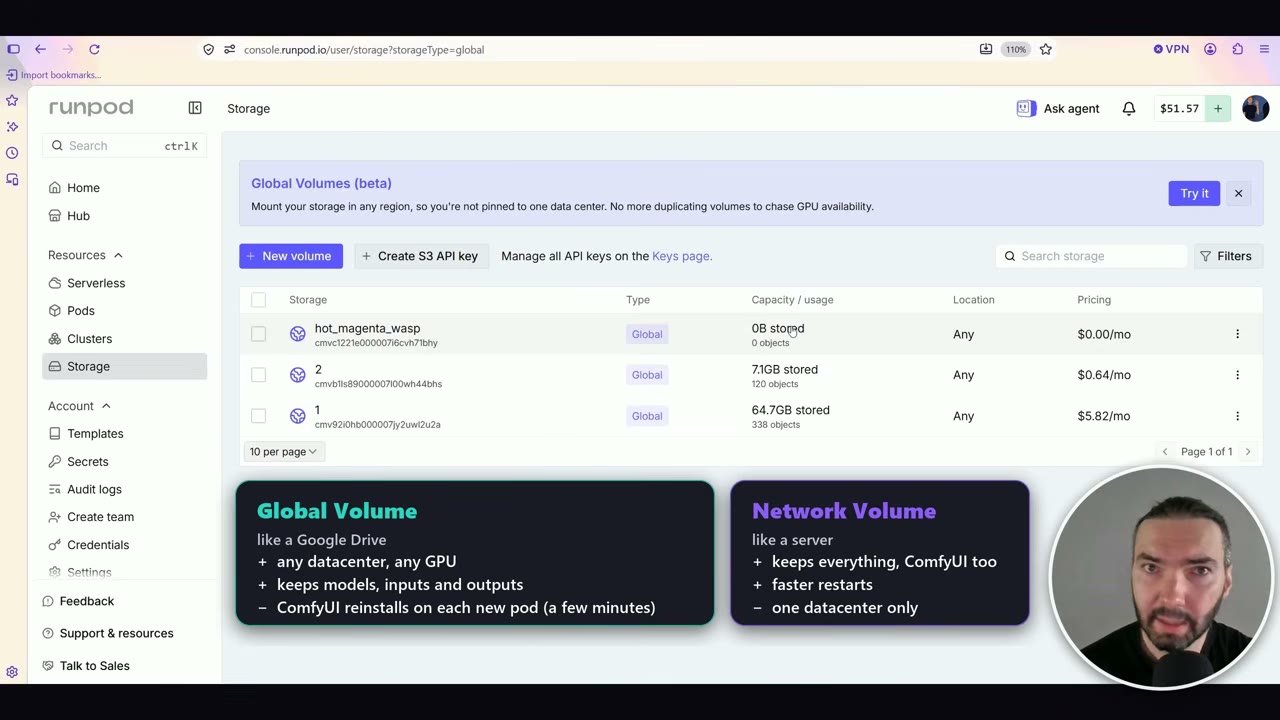
| Volumen global | Volumen de red | |
|---|---|---|
| Qué guarda | Modelos, entradas y salidas | Todo, incluida la instalación de ComfyUI |
| Dónde puedes usarlo | En cualquier centro de datos, así que hay muchas más GPU para elegir | En un solo centro de datos |
| Tiempo de reinicio | Unos minutos más: ComfyUI se reinstala en cada pod nuevo | Más rápido |
| Precio (octubre de 2026) | 0,09 $/GB al mes, solo por lo almacenado | 0,07 $/GB al mes por el tamaño que reservas, esté vacío o no |
Para mí, el factor decisivo es la disponibilidad. Con un volumen de red estás atado a un centro de datos, y ese centro de datos a menudo no tiene GPU libres. Un volumen global se puede conectar a una GPU en cualquier parte.
Además, a mí me sale más barato, porque solo pagas por lo que de verdad está almacenado, facturado por horas. Mi volumen de LongCat ocupa 64,7 GB, lo que sale a 5,82 $ al mes. Bórralo cuando quieras y la facturación se detiene.
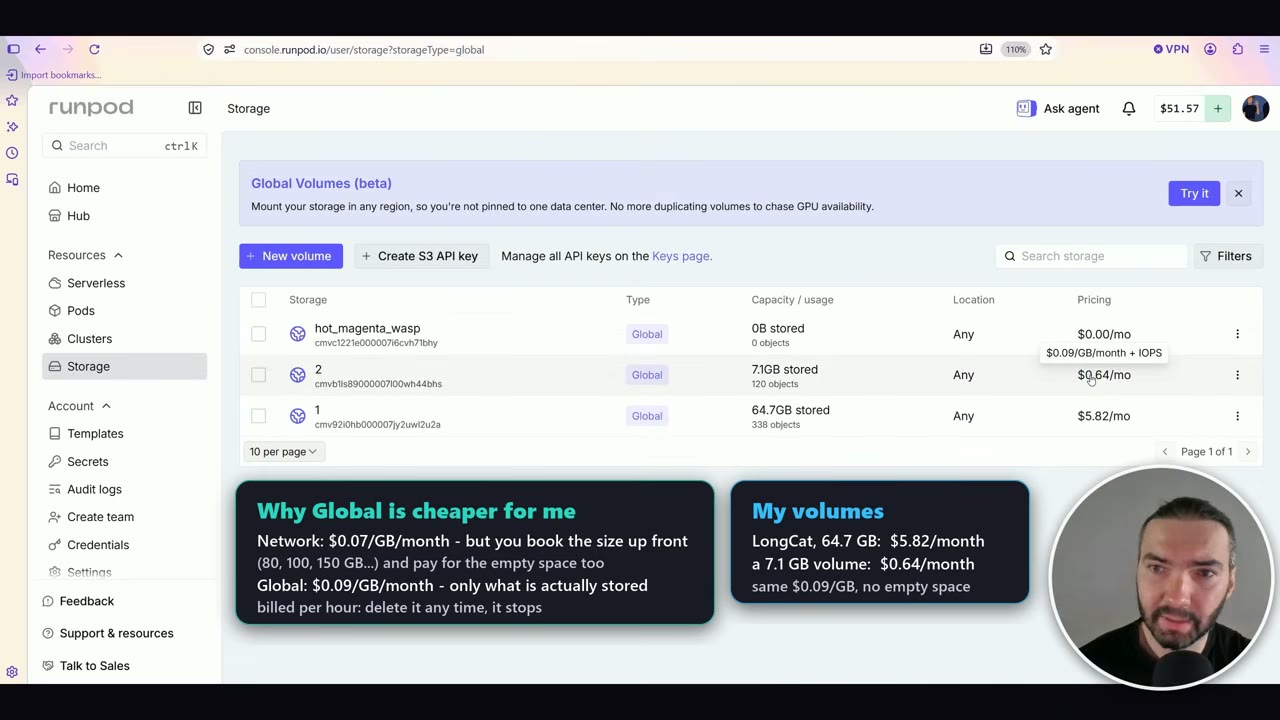
Los volúmenes globales siguen en beta. Una cosa de la documentación de RunPod que conviene saber: si el saldo de tu cuenta llega a 0 $, el volumen global se marca y se borra de forma permanente al cabo de 15 días.
Para prepararlo: abre el enlace de la plantilla, ve a Storage → New volume, elige Global volume, créalo, selecciónalo y haz clic en Configure Pod with volume. La página de despliegue todavía no dice «Global» en ningún sitio, pero el volumen está conectado.
Qué GPU: VRAM y RAM del sistema
LongCat necesita al menos 32 GB de VRAM con el modelo FP8 y más de 60 GB de RAM del sistema. La RAM es la trampa.
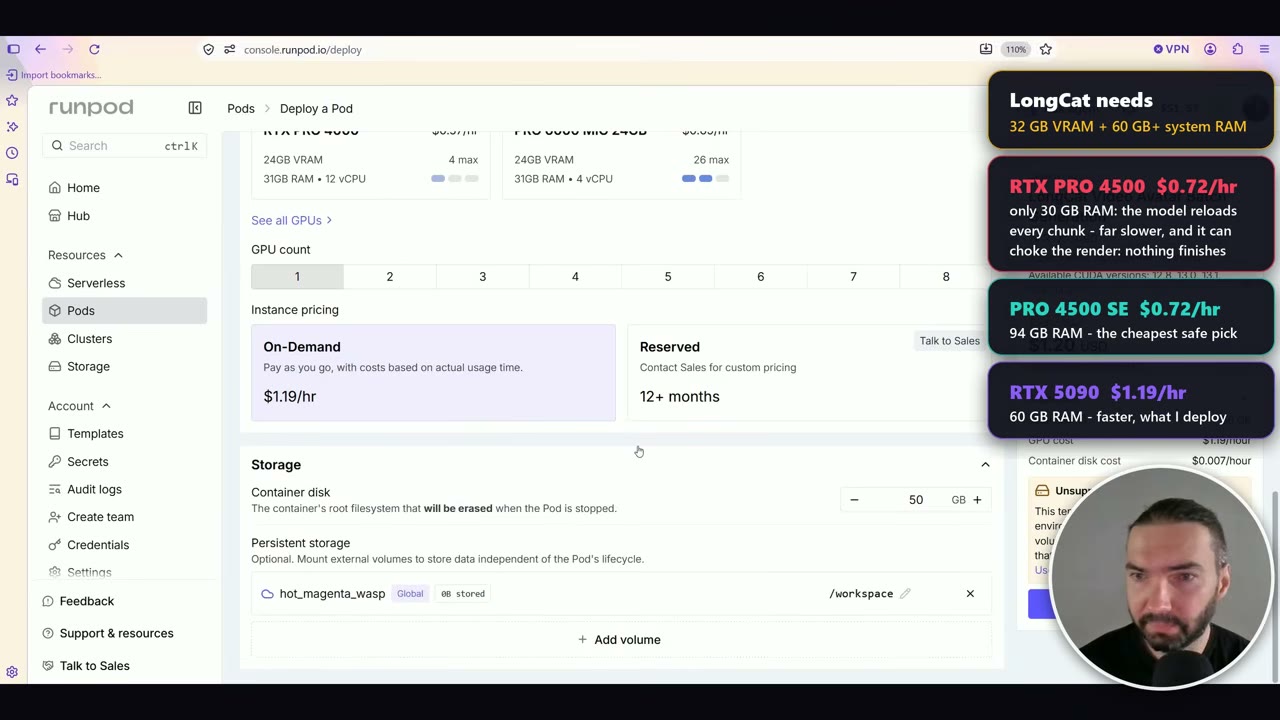
| GPU | VRAM | RAM del sistema | Precio (oct. 2026) | Notas |
|---|---|---|---|---|
| RTX PRO 4500 | 32 GB | 30 GB | $0.72/h | Evítala: el modelo se vuelve a cargar en cada trozo |
| RTX PRO 4500 SE | 32 GB | 94 GB | $0.72/h | La opción segura más barata |
| RTX 5090 | 32 GB | 60 GB | $1.19/h | Más rápida |
| H100 SXM | 80 GB | – | $4.00/h | Ejecuta el modelo BF16 completo |
Con solo 30 GB de RAM, el modelo tiene que volver a cargarse en cada trozo. Eso hace el render mucho más lento y puede bloquearlo por completo.
Despliegue y primer arranque
- Despliega el pod. Puede que veas un aviso “Unsupported volume type” en la página de despliegue. Con esta plantilla puedes ignorarlo sin problema.
- Si dice que no hay recursos, vuelve a hacer clic en Deploy. A veces RunPod necesita un segundo intento.
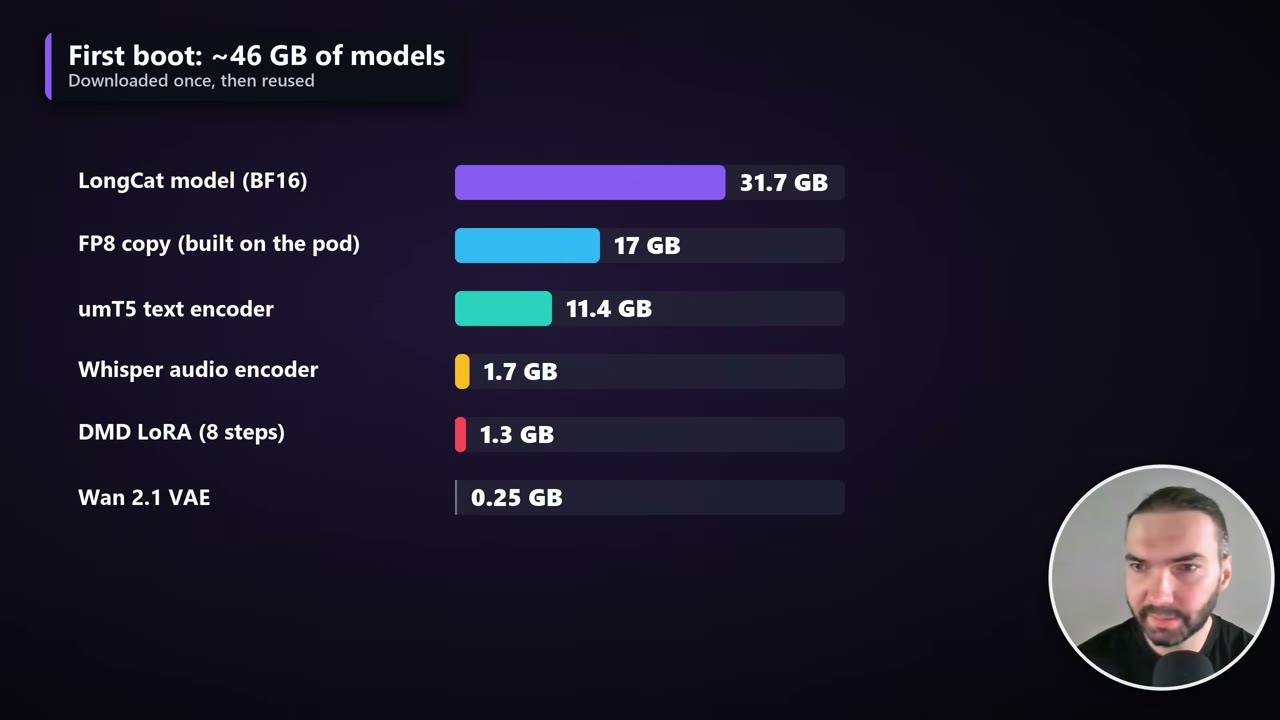
- Espera a las descargas. El primer arranque descarga unos 46 GB de modelos, una sola vez. El pod también crea la copia FP8 del modelo a partir del archivo BF16, así que los modelos ocupan unos 63 GB en total. Los arranques siguientes los reutilizan.
- Si todo se ha descargado pero ComfyUI no arranca, detén el pod y vuelve a iniciarlo. Me pasó durante la grabación.
- Abre ComfyUI y JupyterLab desde el menú Connect del pod. JupyterLab puede seguir diciendo «initializing» cuando en realidad ya está listo, así que prueba a abrirlo.
Los flujos
Abre ComfyUI y luego la barra lateral Workflows. Hay ocho flujos: BF16 o FP8, 640 × 640 o 960 × 960, y una versión de una sola locución o por lotes de cada uno.
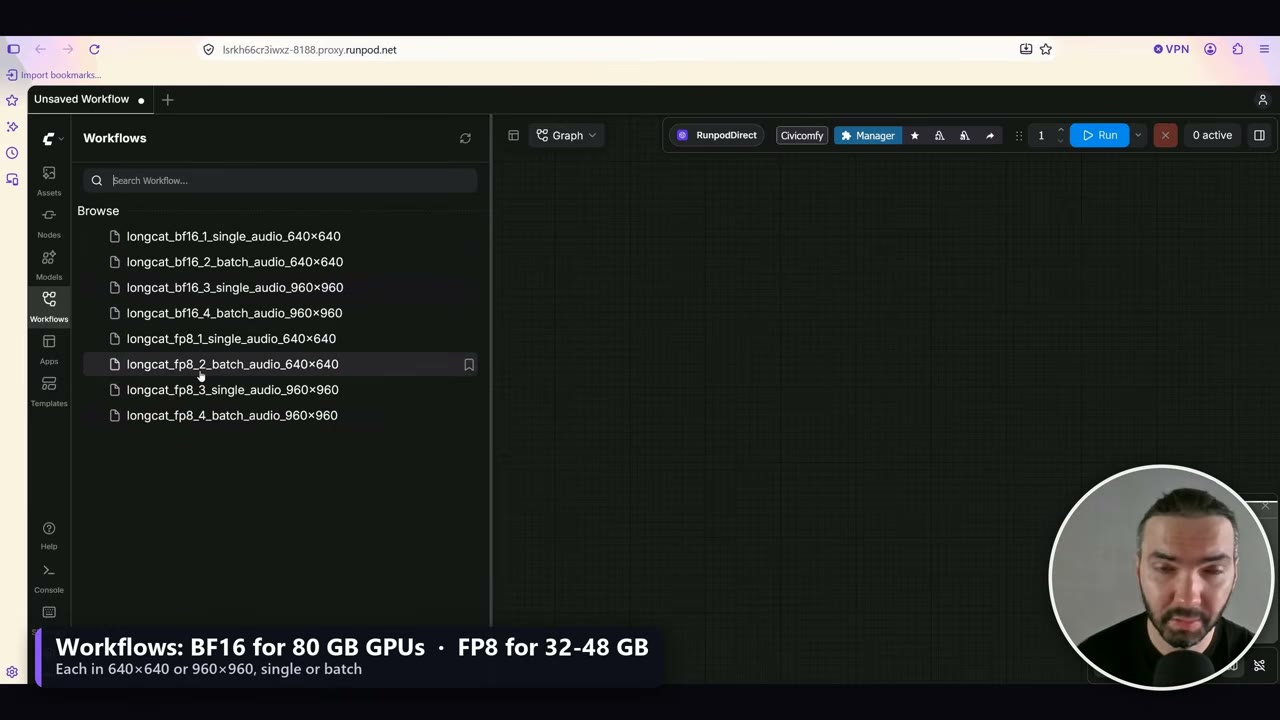
- Single audio renderiza una locución. Se abre con un retrato de ejemplo y una locución de ejemplo de alrededor de un minuto, así que puedes probarlo enseguida.
- Batch audio renderiza todas las locuciones de
ComfyUI/input/batch_audio/, un vídeo por cada una, una tras otra, con el mismo retrato.
Sube tus propios retratos y locuciones con JupyterLab: los retratos a ComfyUI/input/ y las locuciones del lote a ComfyUI/input/batch_audio/.
El prompt es opcional. Para un avatar parlante normal, déjalo en blanco. Puedes pedir algo concreto, como “natural hand movement”.
Mantén las manos en el retrato
LongCat puede mover las manos muy bien. Pero si las manos no están en tu retrato, el modelo tiene que inventarlas cuando entran en el encuadre, y no siempre inventa las mismas.
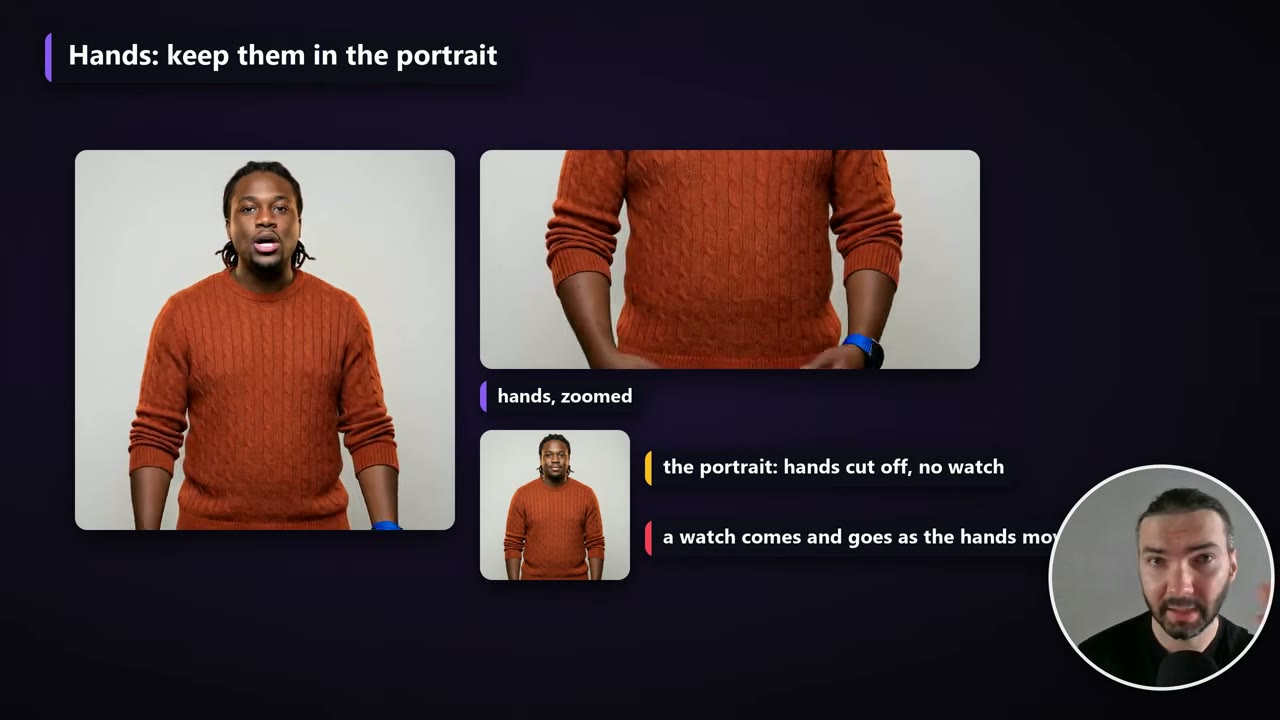
Si quieres movimiento de manos, usa un retrato con las manos visibles, para que el modelo sepa que las manos originales no llevaban reloj. Sigue sin ser una garantía, pero reduce el riesgo.
Cómo evita LongCat la deriva en los vídeos largos
Todos los modelos de avatar renderizan por trozos: ninguno renderiza un minuto entero de una vez. Las ventanas de LongCat duran 3,7 segundos, y ahí es donde se diferencia de los demás.
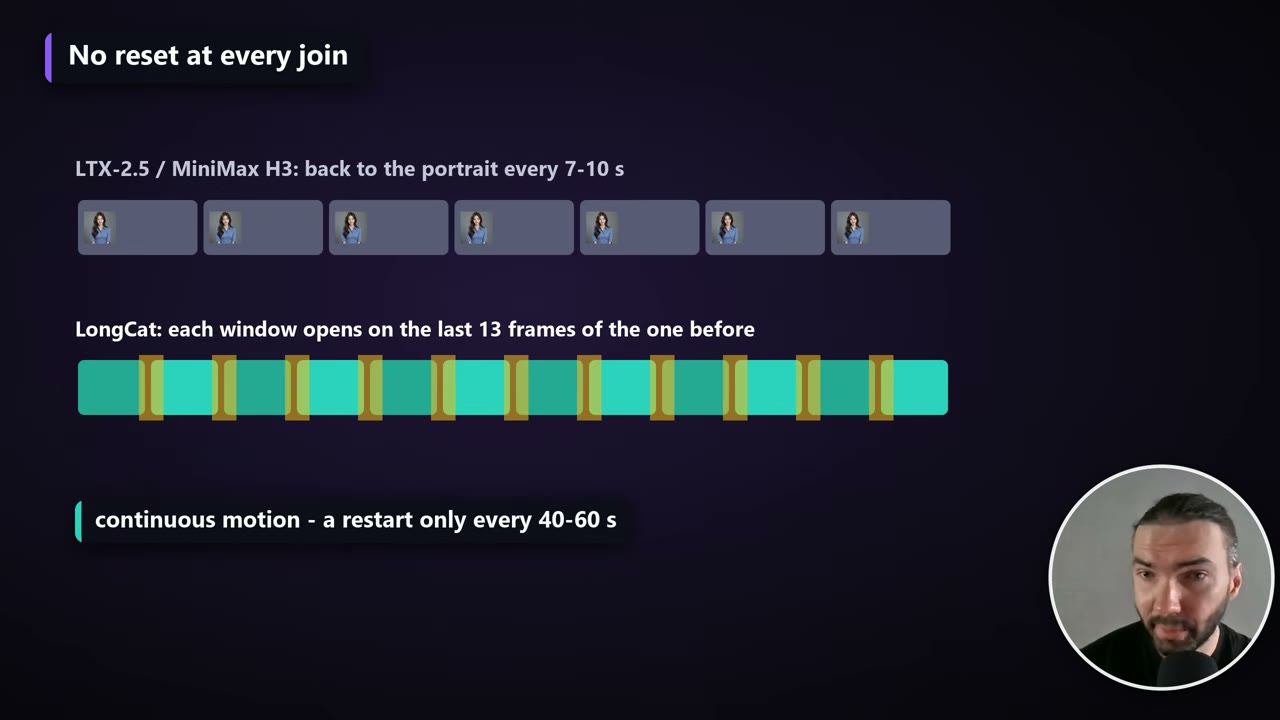
Con mis plantillas de LTX-2.5 y MiniMax H3, cada trozo vuelve al retrato original. LongCat abre cada ventana con los últimos 13 fotogramas de la anterior, así que el movimiento es continuo y no se ven las uniones. La sincronización labial también se mantiene a través de ellas.
Pero la continuación tiene su propio problema. Se mantiene estable unos 40–70 segundos; a partir de ahí, el rostro empieza a cambiar y se acumula ruido, cada vez peor a lo largo de un vídeo de 10 o 20 minutos.
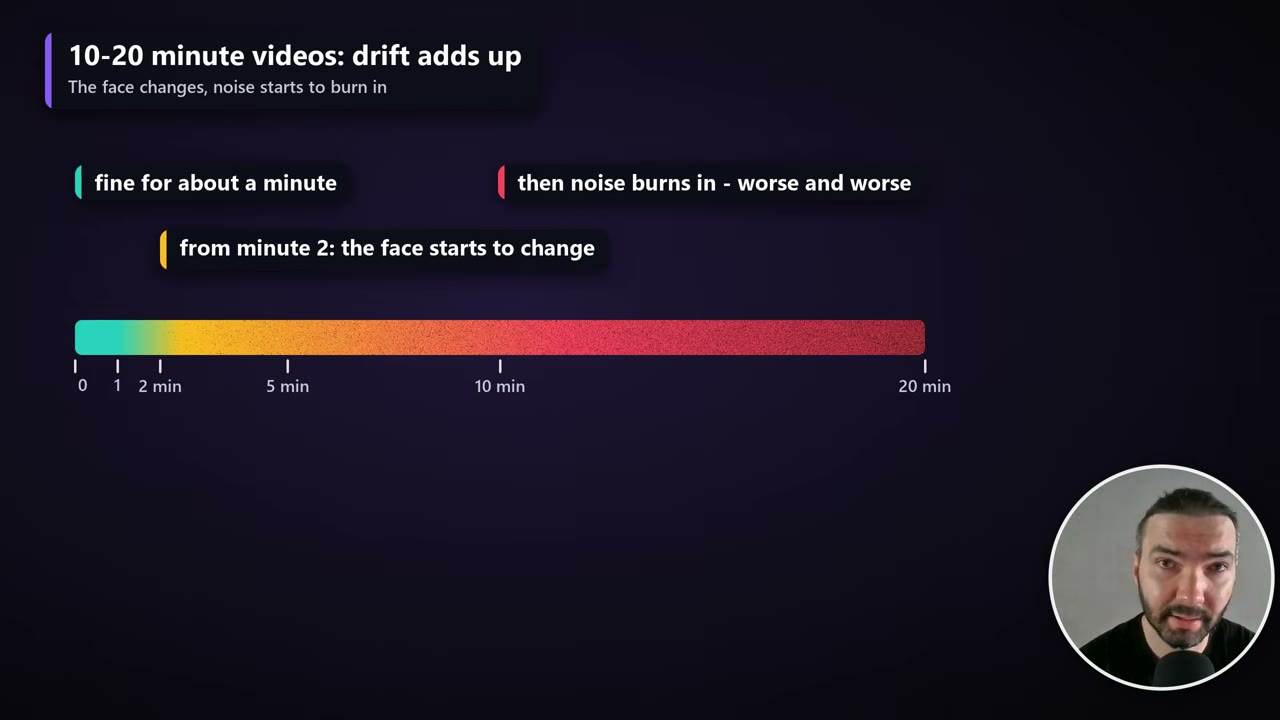
Por eso los flujos fuerzan un reinicio desde el retrato original cada 40–60 segundos. Los reinicios se planifican a partir de la locución completa antes de que empiece el render, y cada uno cae en mitad de una pausa real (al menos 0,4 segundos de casi silencio), así que la boca está cerrada a ambos lados del corte. Se ve un poco como un corte rápido de vuelta al retrato.
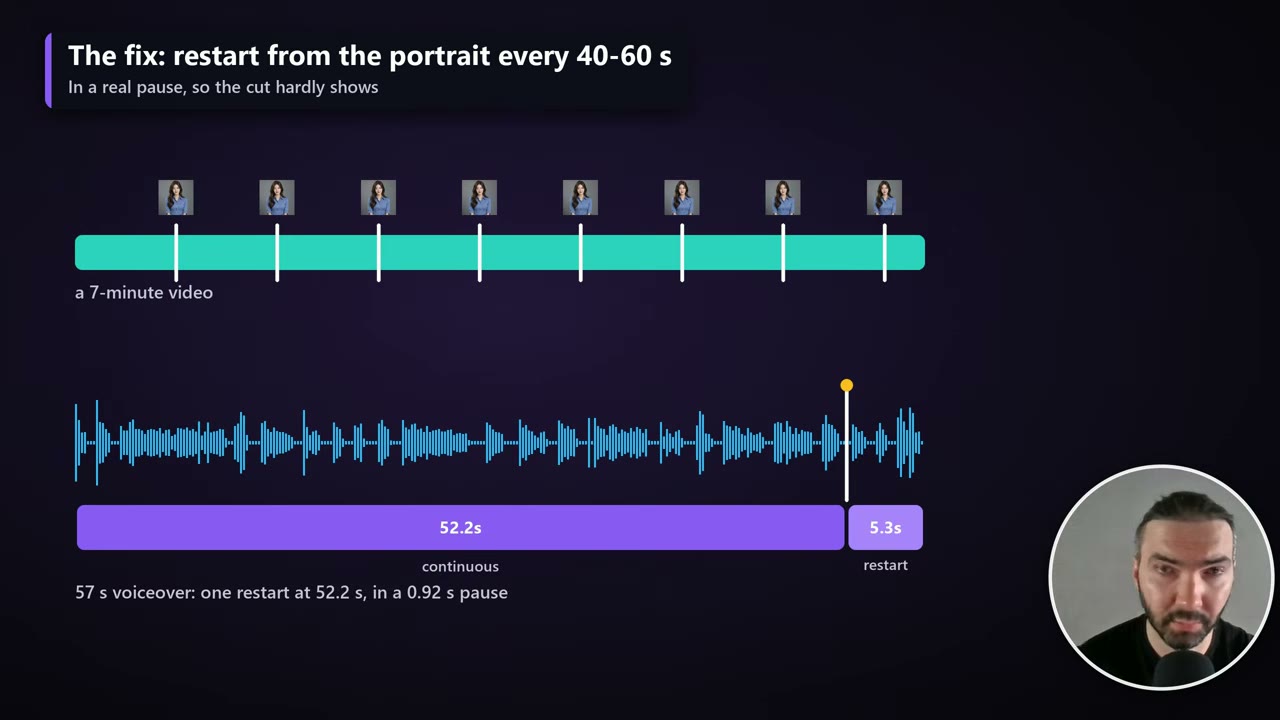
El plan se imprime en el log y se guarda como output/longcat_longform/<name>/restart_plan.txt.
Renderiza
Pon el flujo en cola y observa la consola. Cargar el modelo tarda unos minutos cada vez, así que el primer trozo es el lento. Después son unos minutos por cada trozo de 3 segundos, y por eso un minuto de vídeo acaba tardando alrededor de una hora.
Cada elemento de la cola renderiza el siguiente trozo sin terminar. El README de la plantilla indica que pongas el batch count en al menos la duración de la locución en segundos ÷ 3,2, más un margen; los elementos sobrantes se saltan en milisegundos.
- Los trozos se guardan en
output/longcat_longform/<voiceover name>/. - Si el trabajo se interrumpe, vuelve a ponerlo en cola y continúa desde el último trozo terminado.
- Cuando termina, el vídeo completo se monta en
ComfyUI/output/. Haz clic derecho en JupyterLab para descargarlo.
El único ajuste que merece la pena cambiar
Los flujos tienen muchas notas y funcionan tal cual; no recomiendo cambiar mucho. La excepción es el espaciado de los reinicios: restart_min_seconds y restart_max_seconds en el nodo Split (40 y 60 por defecto).
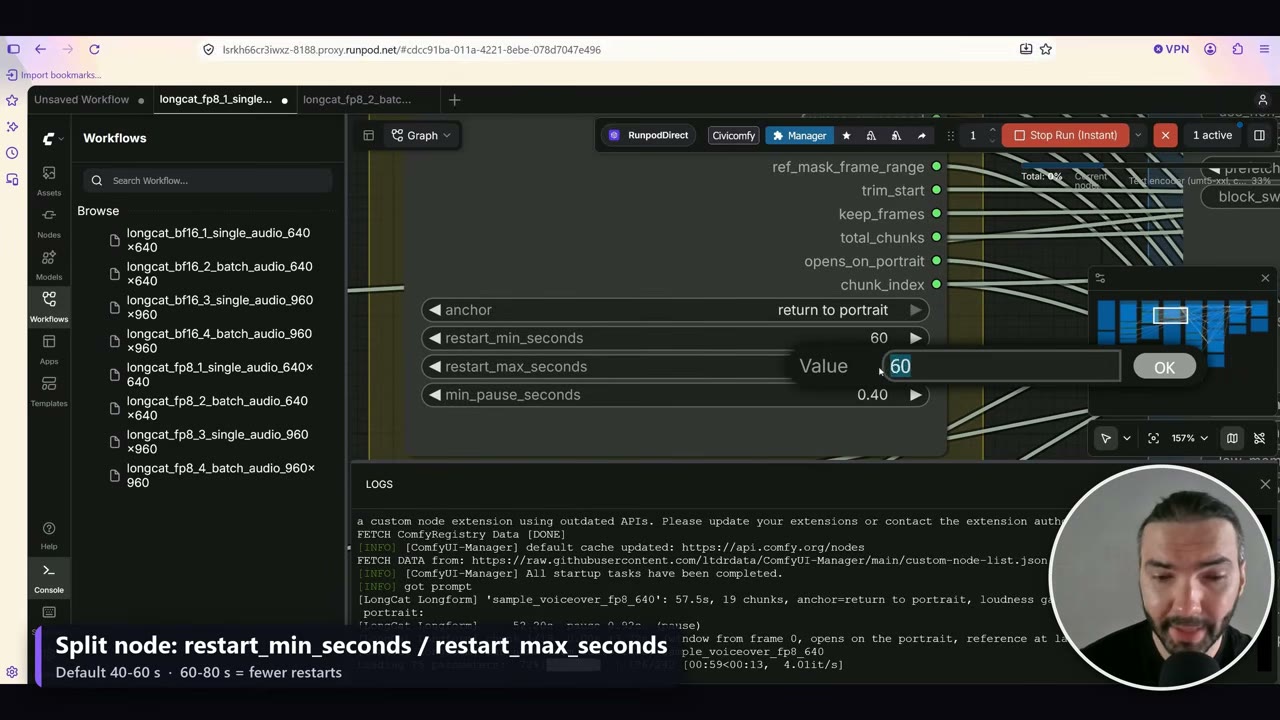
Con 60–80 segundos, el flujo busca una pausa en ese intervalo, así que hay menos cortes de vuelta al retrato.
Cuando termines
Detén el pod cuando el render haya terminado. Tus modelos, entradas y salidas se quedan en el volumen. Cuando el proyecto haya terminado, borra también el volumen, o seguirá facturando.
Errores que evitar
- Elegir la GPU solo por la VRAM. La RTX PRO 4500 normal tiene 32 GB de VRAM pero solo 30 GB de RAM; elige la versión SE o una 5090.
- Usar BF16 en una tarjeta de 32 GB. BF16 es para GPU de 80 GB; usa los flujos FP8 en tarjetas más pequeñas.
- Un retrato sin manos cuando quieres movimiento de manos.
- Lanzarte directamente a un trabajo largo. Comprueba en el primer trozo la sincronización labial, el rostro y el fondo.
- Olvidarte del volumen. Un pod detenido cuesta poco; el almacenamiento factura cada mes.
Regístrate con mi enlace de referido de RunPod y recibirás entre 5 y 500 $ en créditos de RunPod. Sin un enlace de referido no hay bonificación. Yo recibo la misma bonificación y la uso para cómputo.
Ver la versión en vídeo (10:27)
Todo lo anterior también está en el vídeo, si prefieres seguirlo en pantalla. El vídeo está en inglés.
Preguntas frecuentes
¿Cuánto cuesta un minuto de vídeo de avatar parlante con LongCat?
En mis ejecuciones (precios de octubre de 2026): unos 4,02 $ en una H100 SXM a 960 × 960 con el modelo BF16, unos 1,97 $ en una RTX PRO 4500 a 960 × 960 con FP8 y unos 1,03 $ en una RTX PRO 4500 a 640 × 640 con FP8.
¿Cuánto tarda LongCat en renderizar un minuto de vídeo?
Alrededor de una hora en una H100, unas 2,7 horas en una RTX PRO 4500 a 960 × 960 y unas 1,4 horas en una RTX PRO 4500 a 640 × 640.
¿Cuánta VRAM y RAM necesita LongCat?
Al menos 32 GB de VRAM con el modelo FP8, más 60 GB o más de RAM del sistema. Con solo 30 GB de RAM el modelo se vuelve a cargar en cada trozo, lo que es mucho más lento y puede bloquear el render por completo.
¿Por qué el vídeo vuelve al retrato más o menos cada minuto?
LongCat continúa cada trozo a partir del anterior, lo que se ve sin cortes pero se desvía en los vídeos largos. Los flujos reinician desde el retrato cada 40–60 segundos, en mitad de una pausa real, para que el rostro se mantenga fiel.
¿Puedo ejecutar LongCat en local en lugar de en RunPod?
Sí, si tienes la GPU y la RAM. Todo está en GitHub; pídele a Claude o a otra IA que descargue los archivos y los instale en el orden de setup.sh.
Anton Tenitsky es artista 3D con más de 15 años en gráficos por ordenador, que ha trabajado con Nickelodeon, Gameloft, Marvel Rivals y muchos otros clientes. Más sobre mí